Виталий Филатов

о тексте, смысле и красоте

Упрощаем набор статусов статьи

Ещё один частный случай с высокими абстракциями. На этот раз на примере статусов статьи в админке Помощи ВТБ Бизнеса из прошлой статьи.

TLDR. Сперва модель статусов отражала серверную логику, отчего жизненный цикл статьи выглядел сложно. Мы вынесли один из статусов в параметр, и стало попроще, но не всем понравилось.

Контекст и задача

На тот момент из-за особенностей архитектуры продукта статьи Помощи считались частью кода и обновлялись с общим релизом. Просто так править статьи было нельзя. Все изменения собирались в админке, ждали ближайшего релиза и синхронизировались с версией Помощи на проде.

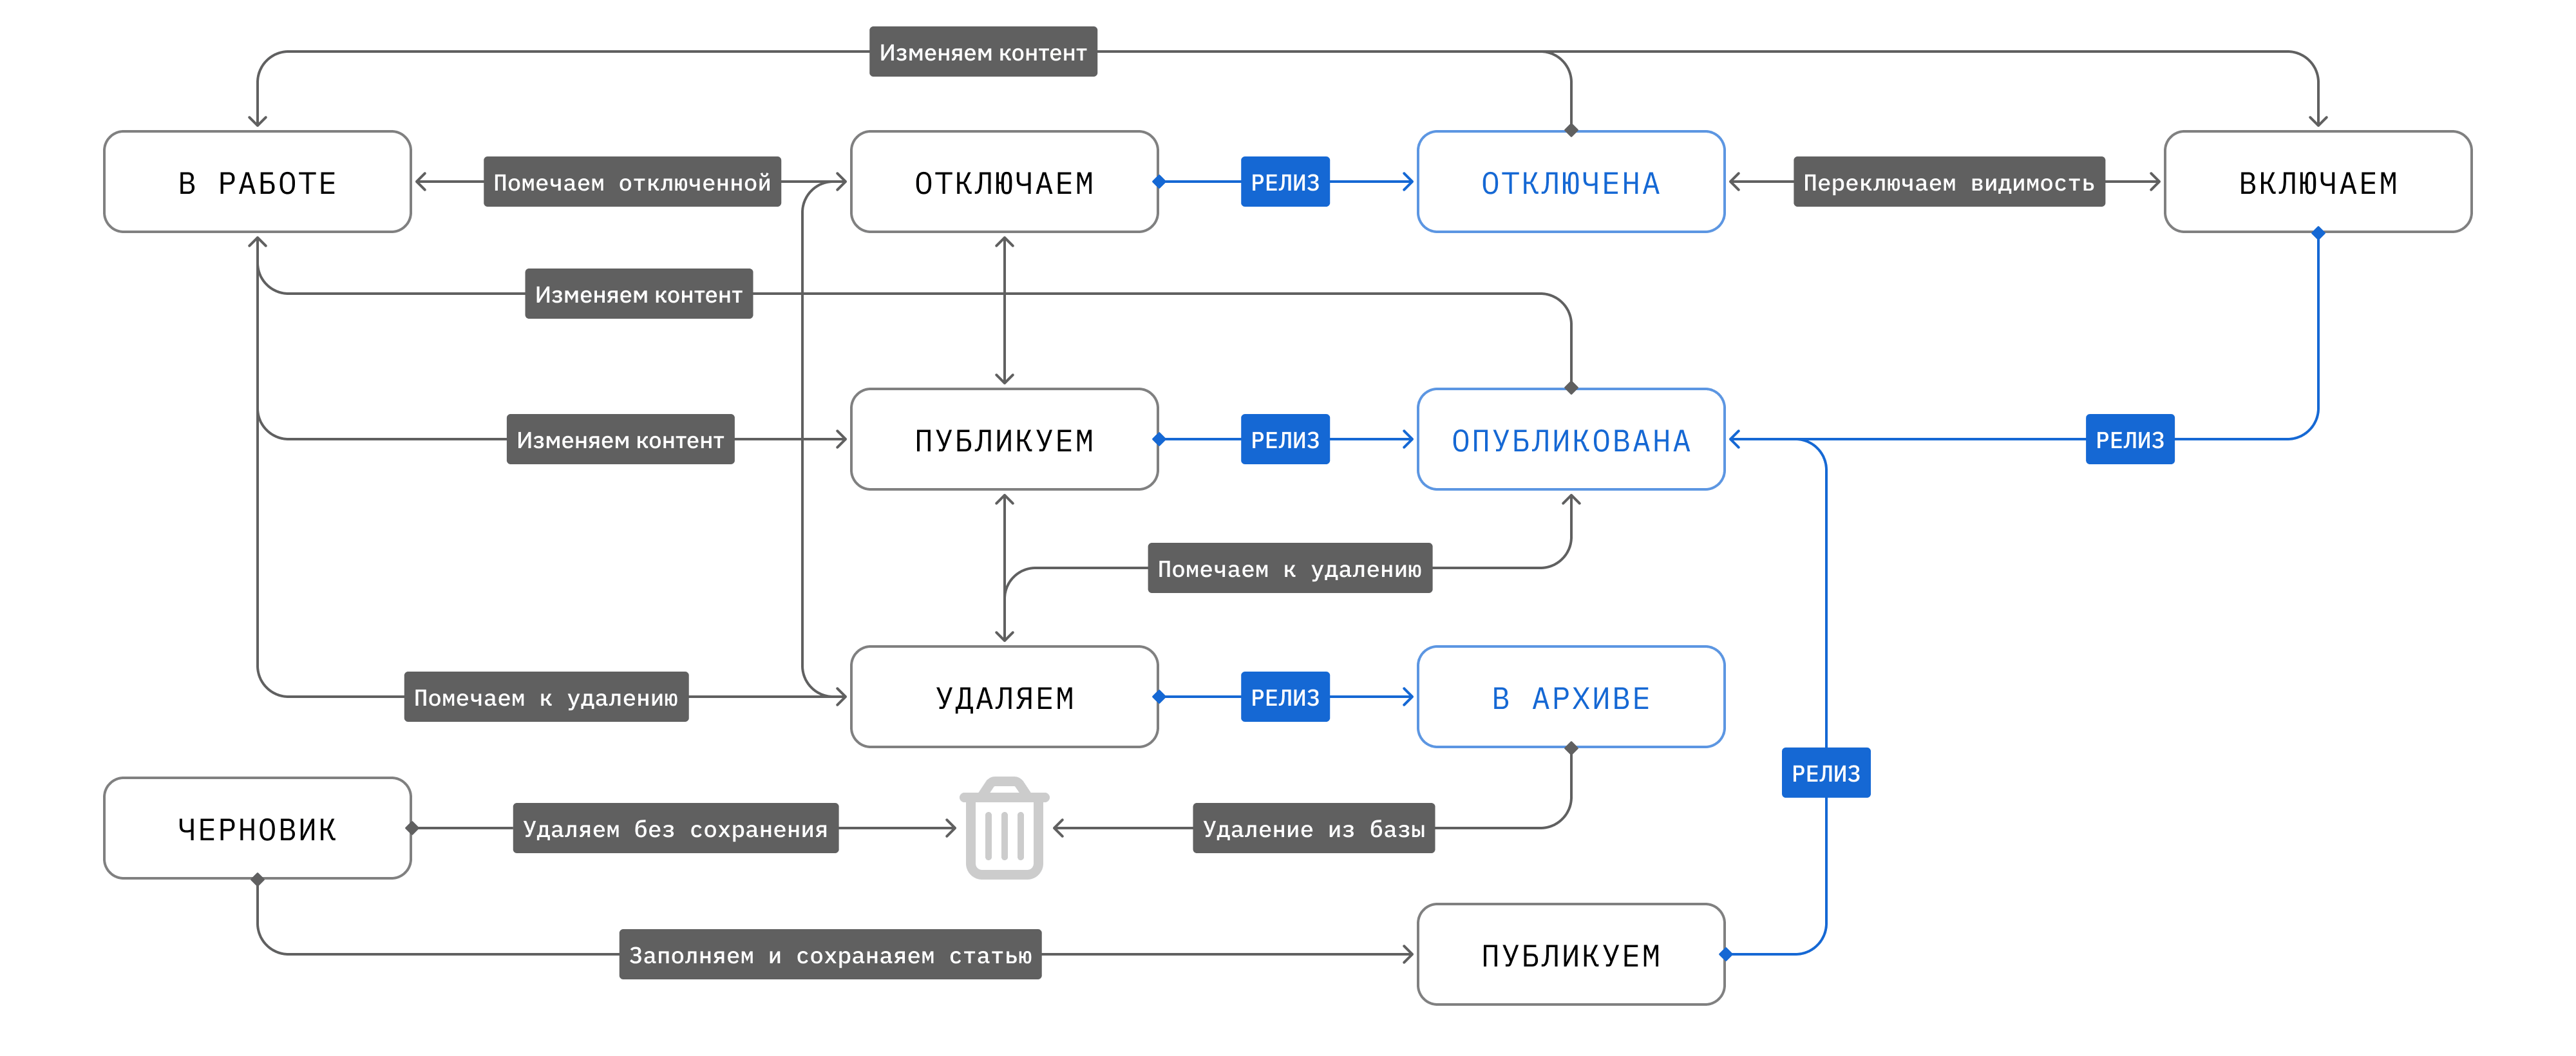
Из-за привязки к общему релизу статусы в админке отражали не только текущее состояние, но и будущие изменения. Кроме того, у опубликованных статей можно было управлять видимостью, что создавало дополнительные статусы.

Статусная модель статьи в админке. Если не сохранять изменения, статья возвращается в предыдущее состояние. Статью нельзя стразу опубликовать скрытой, но почему — уже не помню

Мне доверили придумать краткие и ясные названия статусам, чтобы пользователь меньше путался. Но я сам запутался и решил, что для начала хорошо бы упростить саму модель.

Немного теории

Статусная модель описывает жизненный цикл сущностей, с которыми работает пользователь: заказы, посылки, статьи. Модель объясняет, в каких состояниях объекты могут находиться и по каким правилам переходят из одного в другое.

Редакторам статусная модель интересна тем, что в ней пересекаются миры разработчиков и пользователей.

Для разработчика статусная модель — это модель жизненного цикла объекта данных, она показывает логику работы программы. За прямоугольниками на схеме разработчик видит программный код, схемы баз данных и текст запросов к ним.

Для пользователя статусная модель — важная часть ментальной модели продукта. На её основе пользователь собирает у себя в голове понимание того, как работает интерфейс. Очевидно, чем логичнее для пользователя набор состояний сущности, тем проще: не нужно запоминать значения статусов и сложные схемы переходов.

Хорошую статусную модель пользователь понимает интуитивно

Чаще всего глазами пользователя на статусную модель никто не смотрит, поэтому вместе с ней в интерфейс просачивается логика программного кода. А когда пользователи начинают путаться, редактору поручают лечить проблемы в сценариях формулировками статусов и тултипами.

Решение

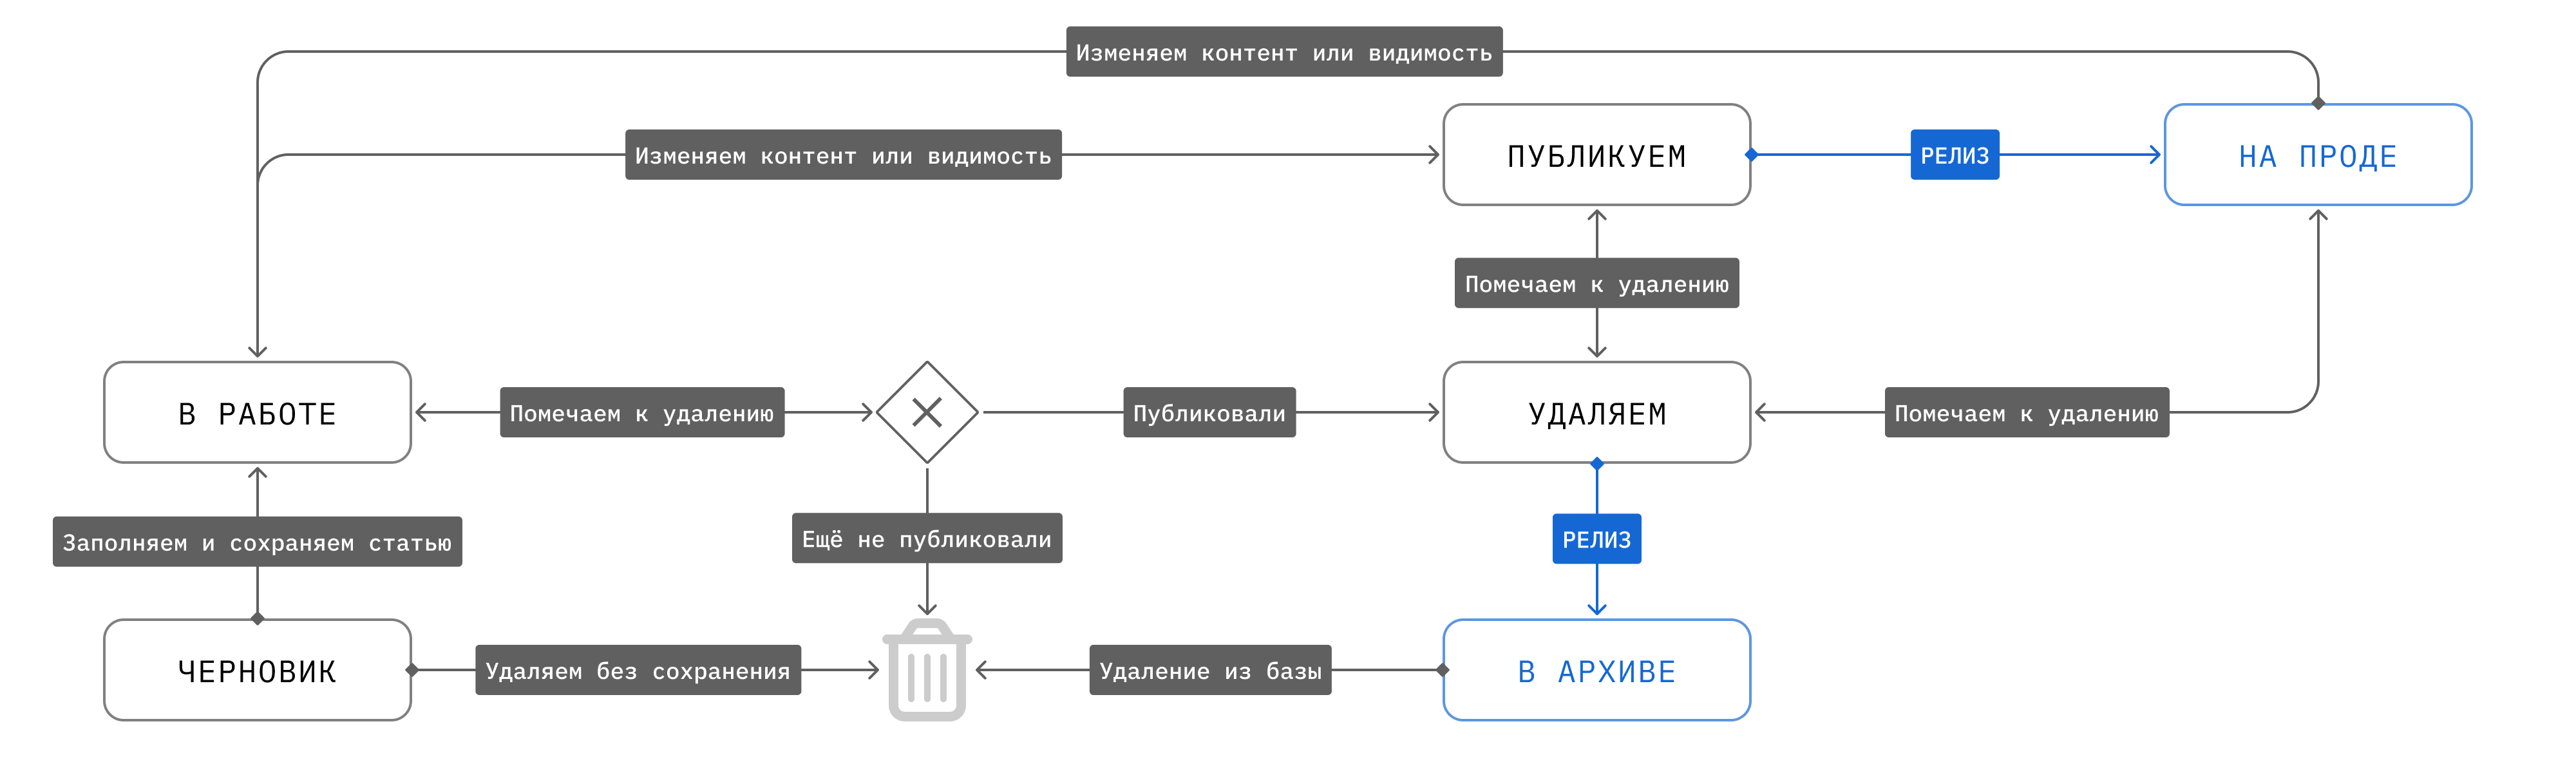
Я предложил сделать видимость статьи одним из параметров, как её название или ключевые слова. В этом случае мы бы переключали видимость флажком в настройках и катили изменённую статью на прод. Такой подход не сильно менял структуру баз данных, но здорово упрощал схему состояний и переходов:

Если видимость сделать параметром, отдельные статусы для включения и выключения не понадобятся

По этой же логике можно было бы вынести в параметры и удаление, но его решили оставить отдельным статусом для удобства. Кнопка «Удалить» перемещала статью в статус «Удаляем» и заменялась на «Отменить удаление».

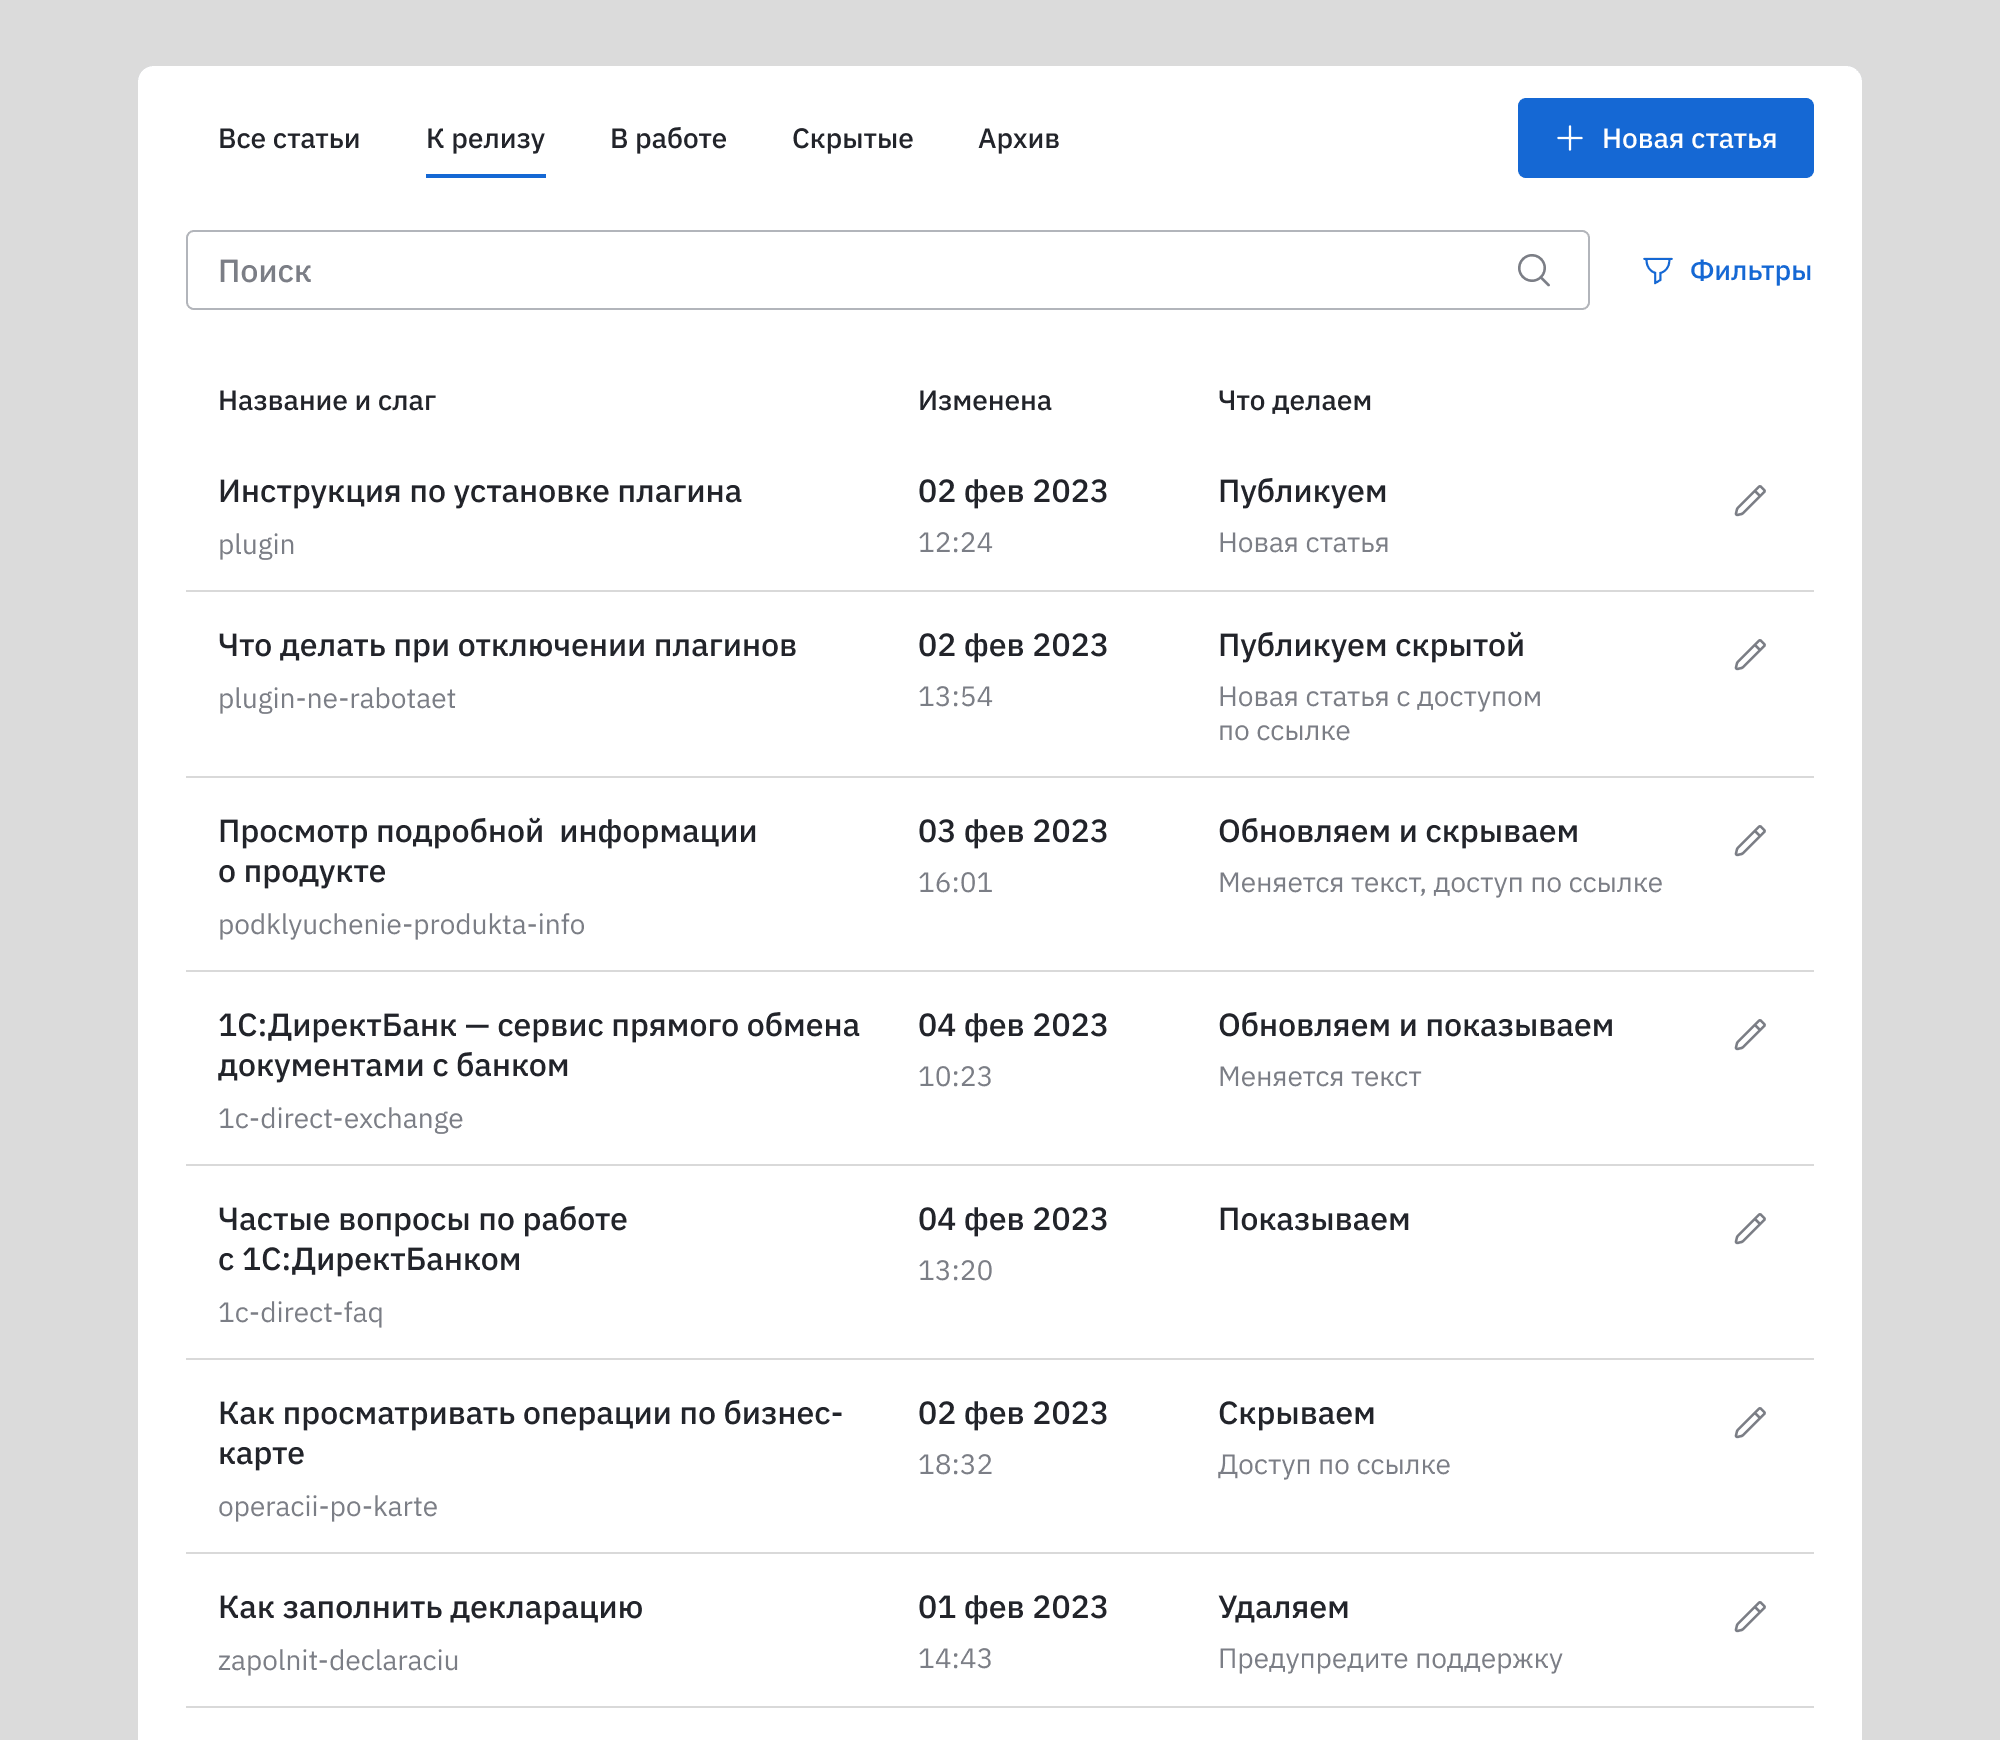
В интерфейсе я предложил вынести статьи к релизу в отдельную вкладку и показывать там не статусы, а описание изменений.

Фрагмент условного интерфейса админки со списком публикуемых статей

Аналитику такое решение показалось непривычным и избыточным, мнения разделились. К счастью, пока мы спорили, публикацию статей удалось отвязать от релизного цикла, и набор статусов упростился сам собой.

 177    Нет комментариев   5 мес   UX   ВТБ   кейс

Редакционные процессы Помощи ВТБ Бизнеса

История о том, как рерайт статей превратился в реорганизацию процессов производства.

Ситуация и задача

В 2020 году ВТБ открыл интернет-банк для малого и среднего бизнеса — ВТБ Бизнес. Он служил витриной для уже существовавших банковских продуктов, которые вели автономные команды — СУБО. Такая архитектура не предусматривала единой языковой службы, да и мода на большие редакции до банка ещё не добралась. В команде платформы уже был редактор, но он занимался в основном задачами маркетинга, а статьи для справочного раздела каждое команда-СУБО писала сама.

Статьи публиковались в сервисе «Помощь», который вела специальная команда внутренних сервисов. Руководителя этой команды беспокоило неравномерное качество этих статей, и он решил нанять второго редактора, переписывать за бизнес-аналитиками и наводить красоту. Так в команде Помощи появился я.

На момент моего появления работа была организована так:

  1. Каждое СУБО отвечало за свои статьи и никого к себе не пускало. Аналитики и юристы не умели писать пользовательские инструкции, поэтому ограничивались односложными ответами на частые вопросы, а стиль и глубина изложения сильно отличались.
  2. Исходники статей хранились в эксель-таблицах у каждого СУБО. Авторы сами делали иллюстрации из скриншотов на тестовом сервере и заливали в общее облако.
  3. Когда нужно было что-то изменить или добавить, бизнес-аналитик СУБО правил свою таблицу, выделял изменения цветом и присылал новый файл по почте команде Помощи.
  4. Там текст из файла вставляли в базу данных и выкатывали на прод с общим релизом.

Процесс получался хаотичным: версии статей не отслеживали, файлы таблиц дублировались, актуальные правки терялись, картинки разных СУБО перетирали друг друга из-за совпадающих имён. Оперативно выложить что-то было невозможно из-за релизной политики, поэтому иногда статьи успевали обновиться несколько раз до релиза и окончательно всех запутать.

Чтобы упорядочить процесс, команда Помощи написала специальную админку с визуальным редактором, где авторы смогли бы работать со статьями без посредников. Но качество от этого не росло, а править и согласовывать текст в админке было так же муторно, как и в эксель-таблицах. Так что я составил план, заручился поддержкой команды и переделал сам подход к производству.

Работа с материалами

Первым делом я убедил команду, что писать статьи и следить за структурой разделов нужно нам самим, а СУБО оставить только сбор фактуры, обновление макетов и согласование. Уже опубликованные статьи мы решили постепенно переписать по мере изменений в продуктах.

СУБО не обрадовались потере контроля, но после нескольких согласованных статей они обычно убеждались, что редактор бережно передаёт смысл, начинали доверять и охотнее рассказывать о бизнес-логике и нюансах.

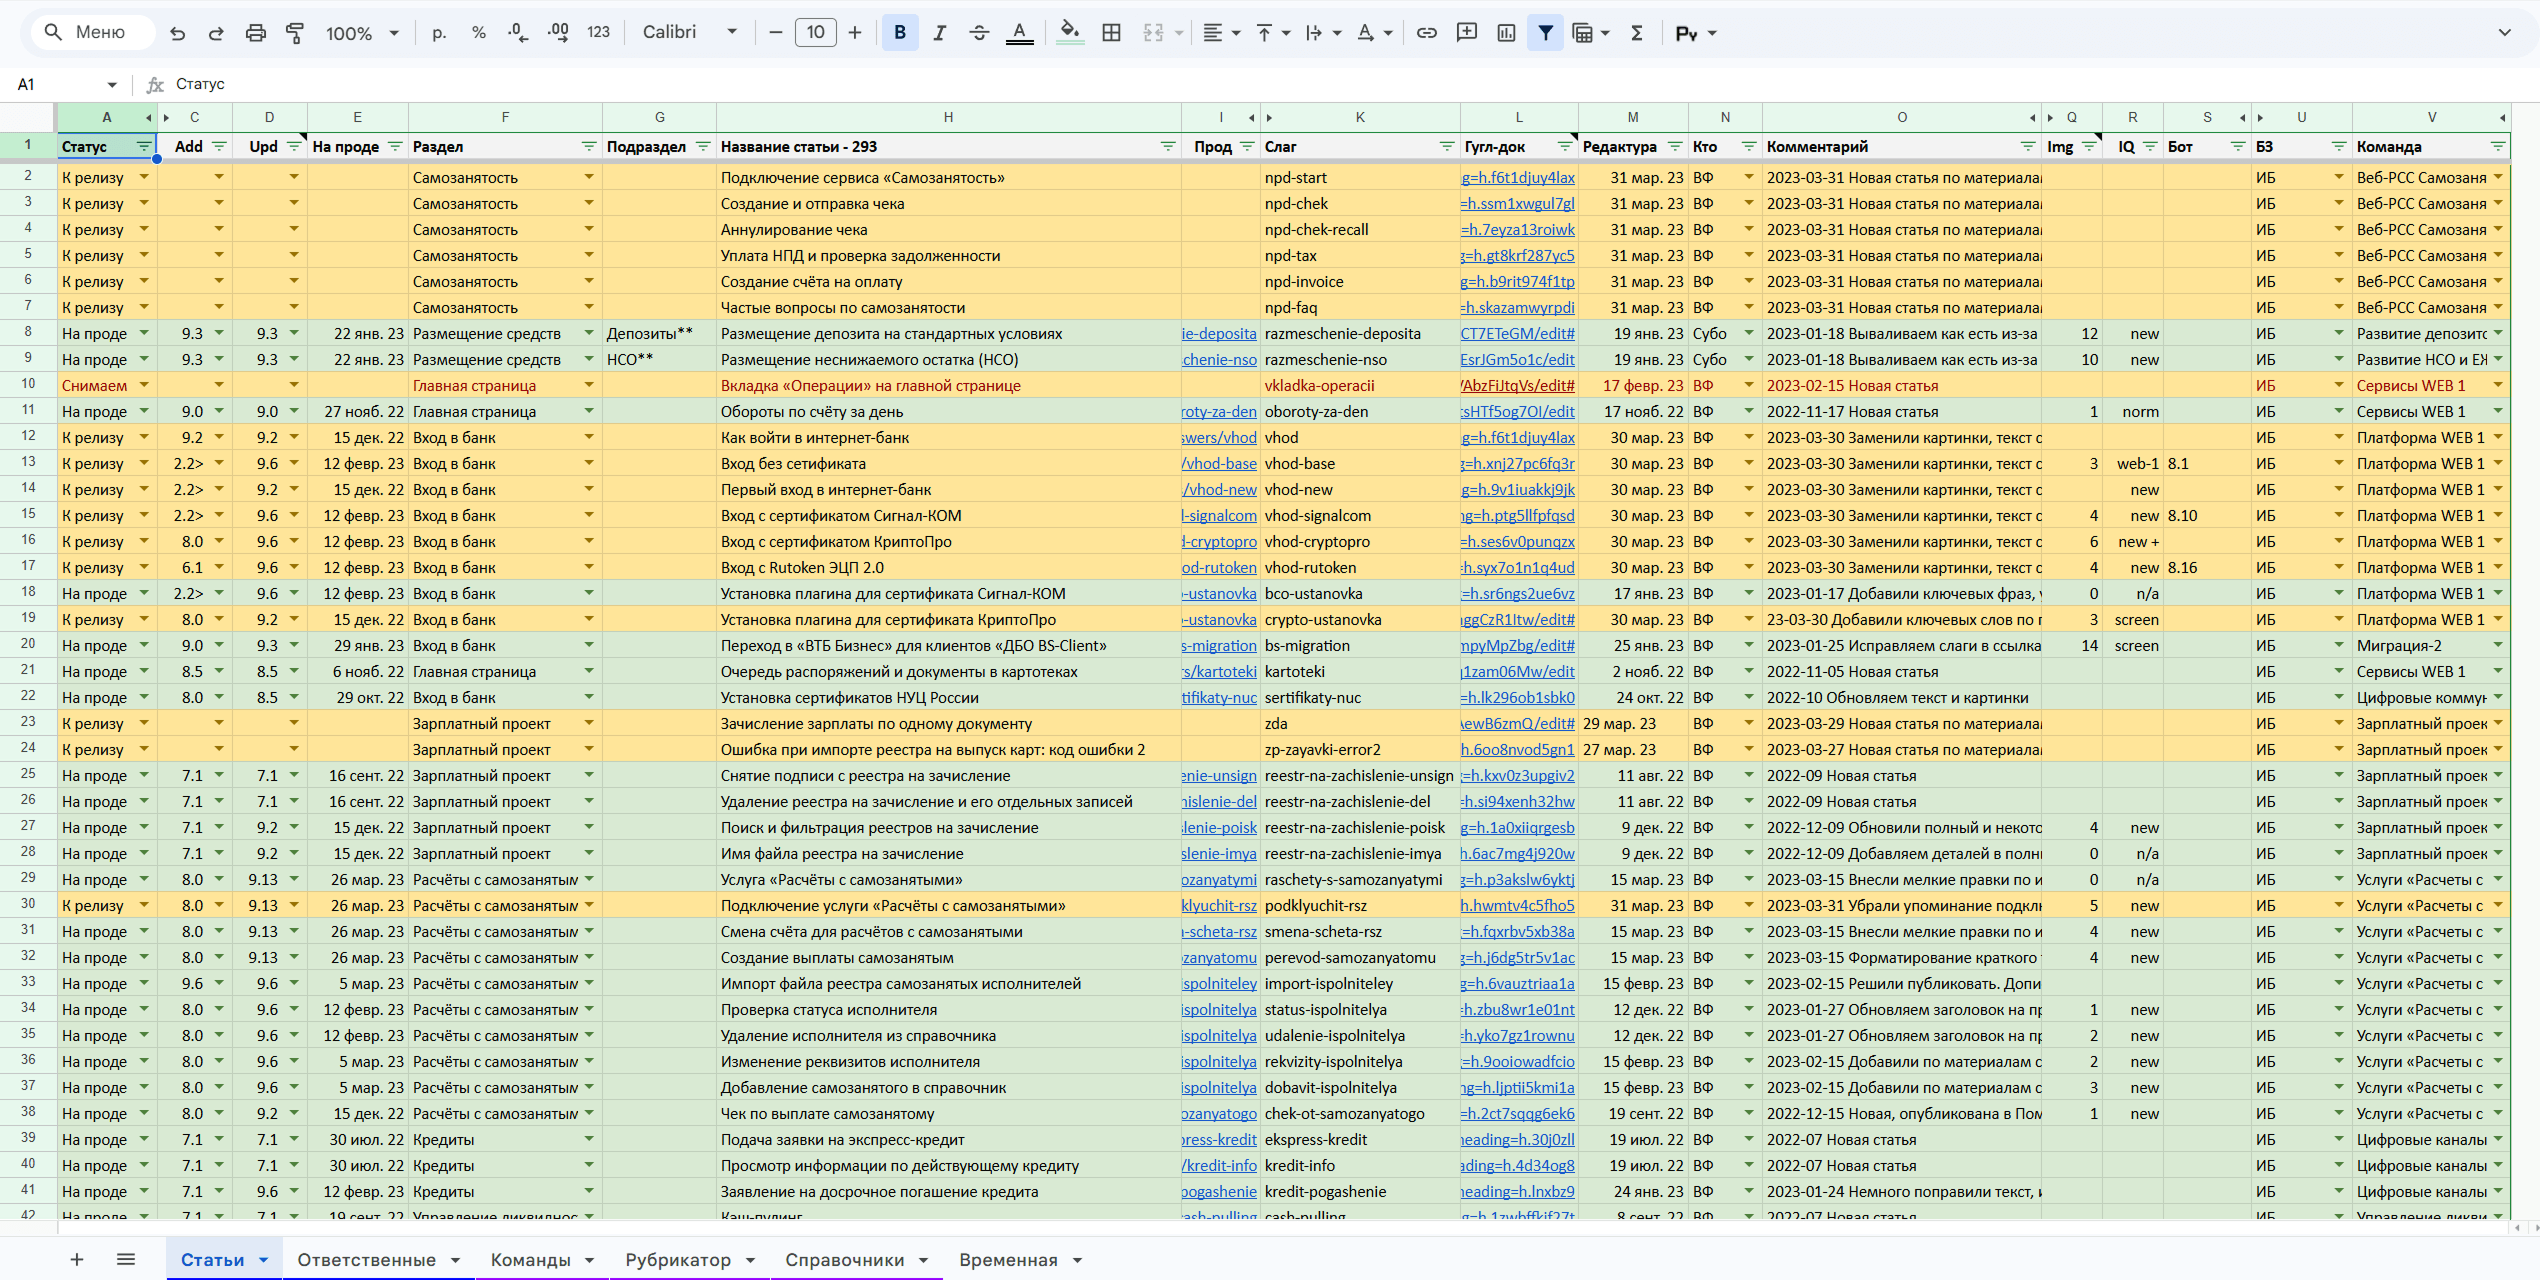
Мы перенесли все статьи в гугл-доки, а ссылки на них и служебную информацию собрали в сводной гугл-таблице. Таблица решала две задачи: хранила статьи со статусами и служила функциональным прототипом для следующих версий админки Помощи.

Сводная таблица — сердце системы контента. Там мы хранили все статьи, включая снятые с публикации, отменённые и удалённые. Вся таблица в гигантском PNG, 2 Мб

В первой версии админки не было инструментов согласования, поэтому их заменяли гугл-доки. Мы гибко настраивали доступы, вели архив версий, принимали и согласовывали правки. Особый шик давала совместная работа: на сложных согласованиях я приглашал всех следить за моим курсором в документе и правил текст прямо во время звонка, без расшаривания экрана.

Гугл-доки помогали и в вёрстке. Я подогнал шаблон статьи максимально близко к дизайну прода и при редактировании сразу видел примерную форму абзацев и переносы строк.

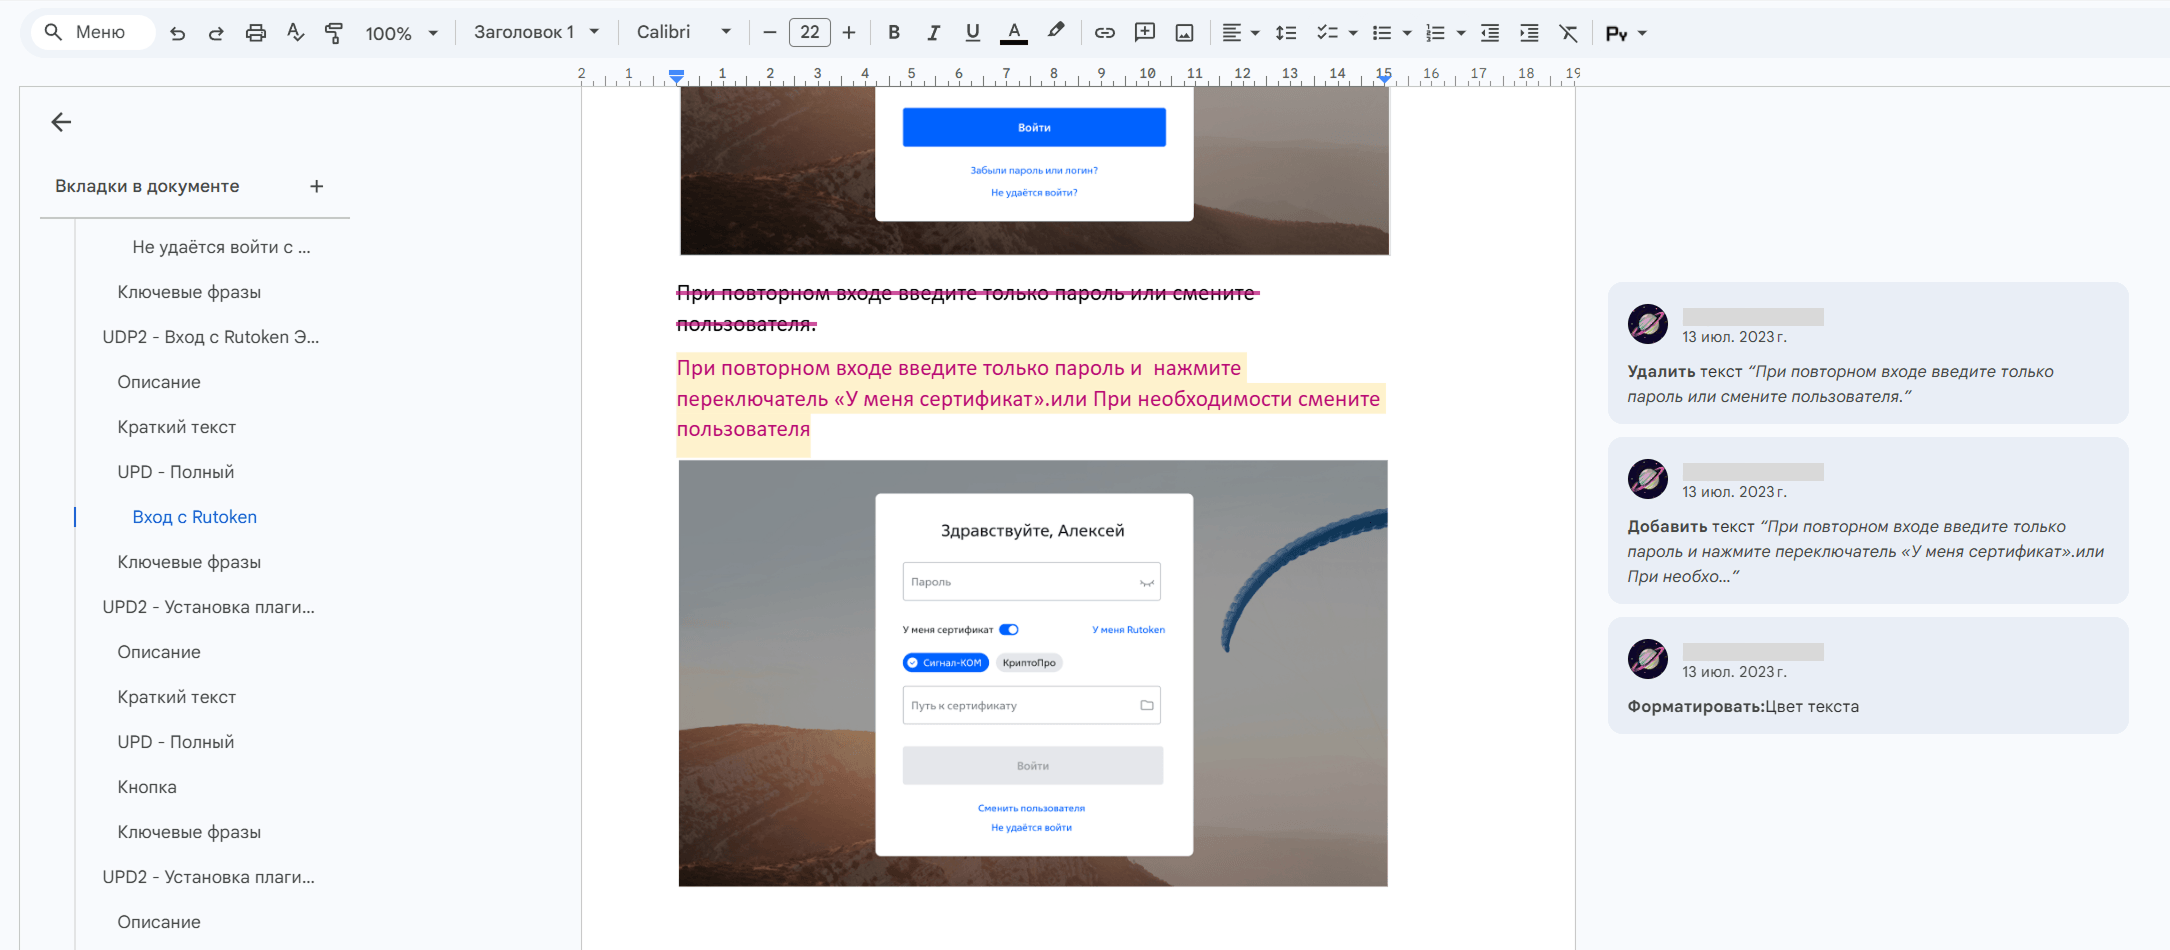
Аналитики и юристы могли комментировать исходники в любое время, я оперативно разбирал правки и публиковал обновления с ближайшим релизом

Далее мы убрали автогенерацию слагов — уникальных частей в URL-адресах статей. Первоначально слаг создавался транслитерацией заголовка, но адреса получались длинными и нечитаемыми. Я предложил составлять слаги силами редактора, чтобы адреса получались понятнее, умещались в СМС и не разрывали сообщения чат-бота.

Срок действия дополнительных опций к пакетам услуг
↓
db.vtb.ru/faq/answers/srok-dejstviya-dopolnitelnyh-opcij-k-paketam-uslug
↓
db.vtb.ru/faq/answers/srok-dop-optsii

Уникальностью слагов отслеживали по сводной таблице и проверке на дубли в админке.

Поскольку слаги менялись крайне редко, я включил их в имена файлов иллюстраций. Такие имена не повторялись, и по ним можно было фильтровать файлы в хранилище. Папки в облаке также назывались слагом статьи.

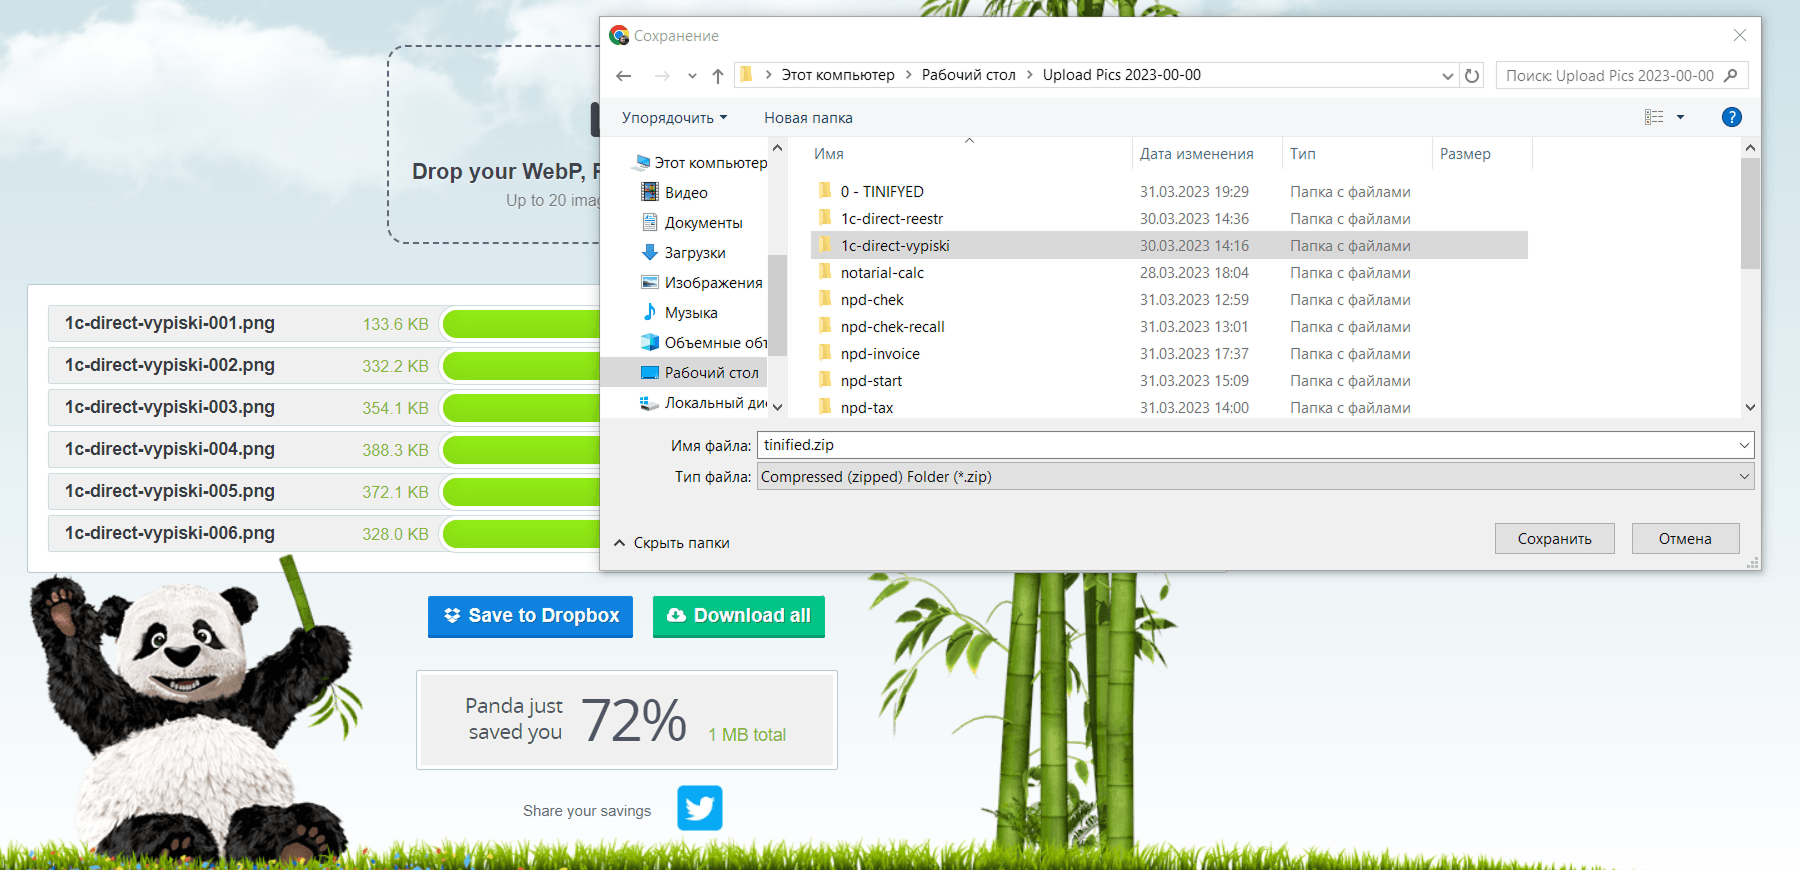
Имена файлов упрощали рутину. Например, пожав пачку картинок в тинифаере, я сразу знал, куда сохранять архив с результатом

Перешли со скриншотов интерфейса на макеты в Фигме. Пришлось искать подход к дизайнерам СУБО и убеждать их обновлять макеты к релизам, но оно того стоило. Иллюстрации стали чище и консистентнее, а их исходники были всегда доступны. Но главное — мы смогли показывать все нужные состояния интерфейса, а не только те, что получалось поймать на тестовом сервере.

Сначала я готовил иллюстрации сам, чтобы изучить нюансы и сформулировать правила. Позже собрал всё в гайд для дизайнеров, и они начали мне помогать.

Гайд по изображениям для статей Помощи получился наглядным: все картинки в нём собраны по требованиям гайда, чтобы читатель сразу видел образец.

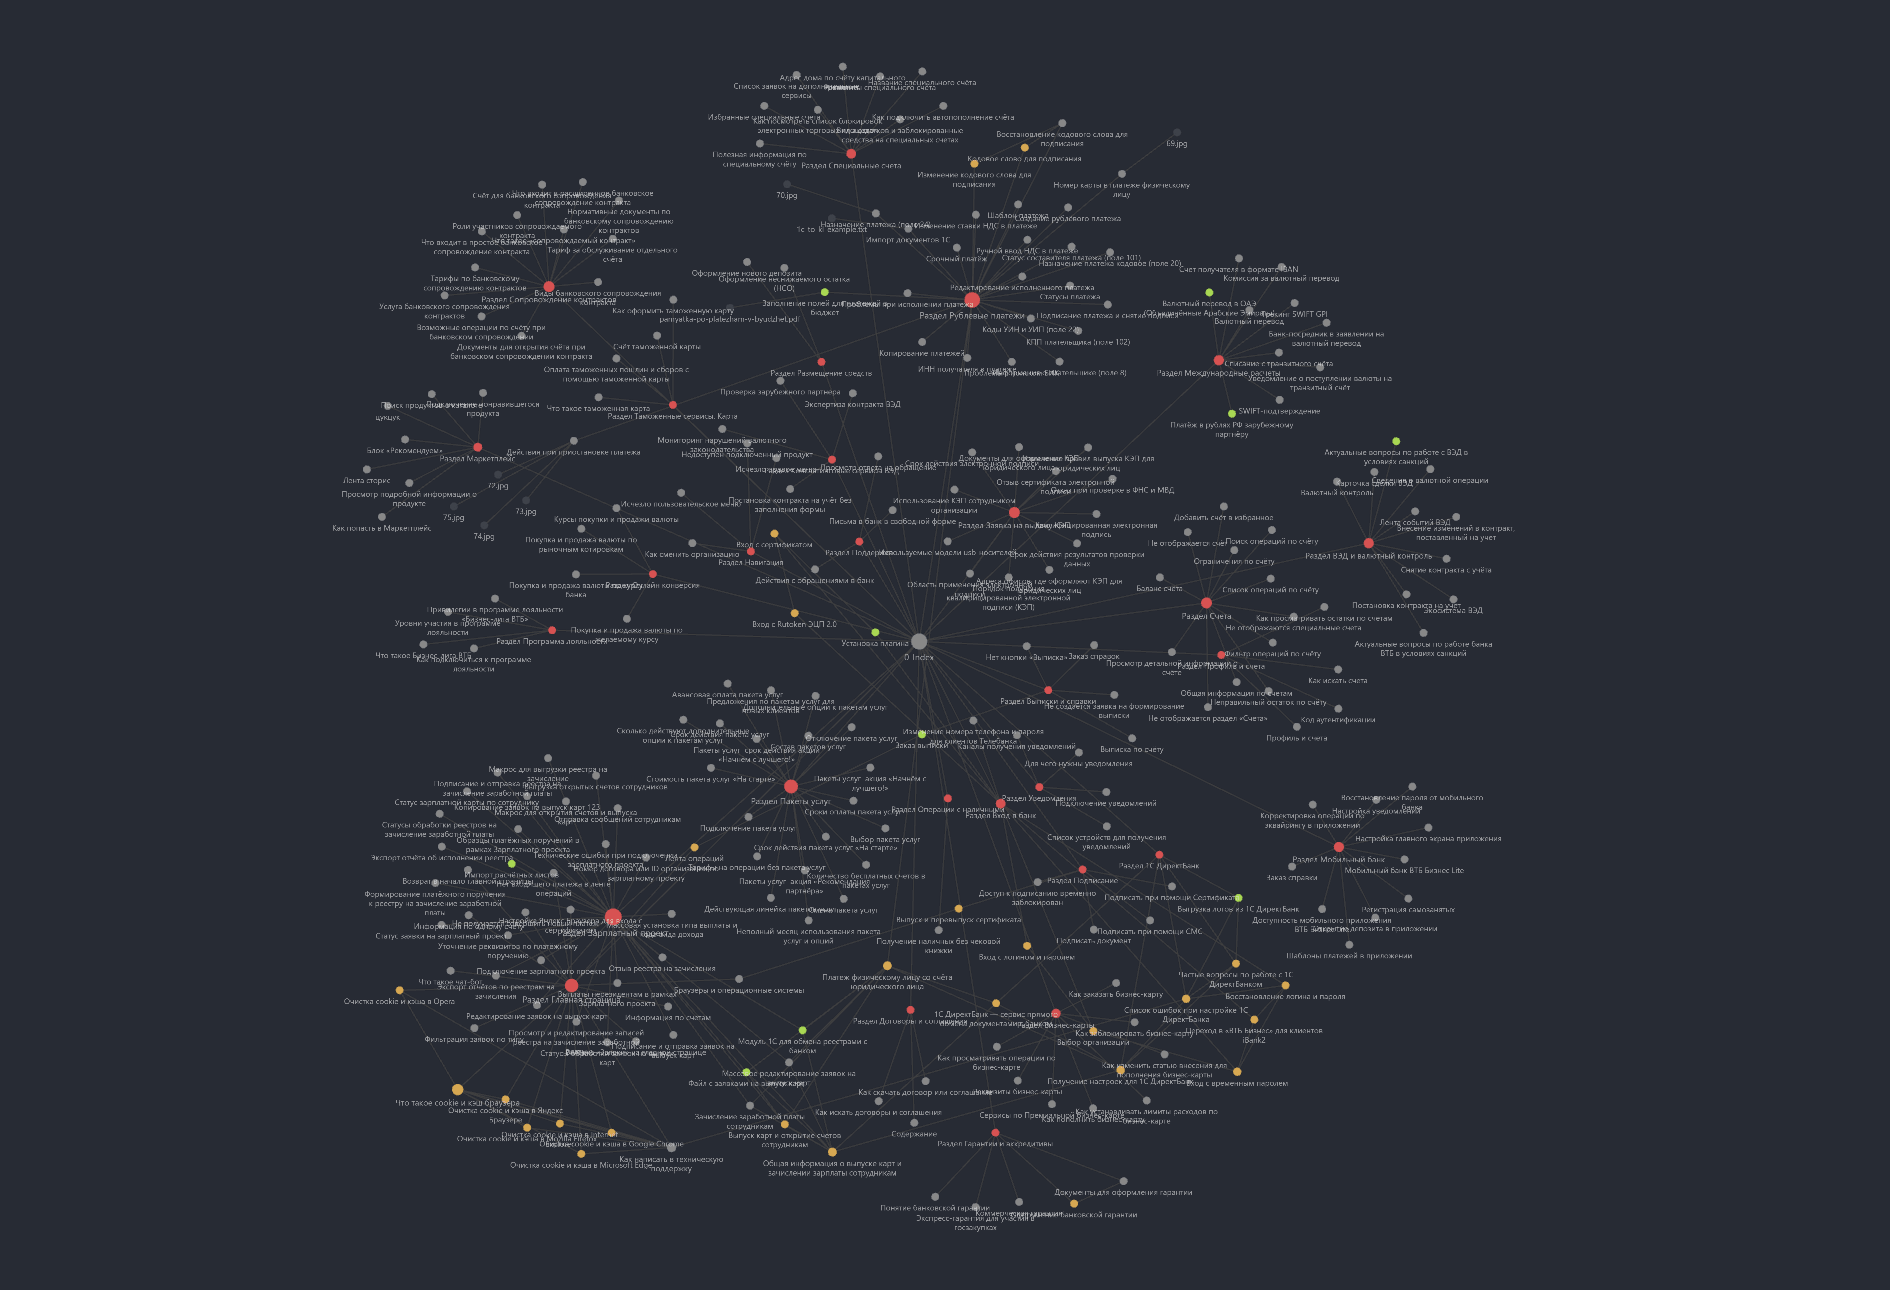
Создали наглядный прототип в Обсидиане, где отслеживали структуру каталогов, связи между статьями, выпавшие иллюстрации и ссылки на файлы. Чтобы не делать это руками после каждого крупного обновления, я собрал требования, а аналитик Евгений написал скрипт на Питоне.

Граф опубликованных статей в Обсидиане. Красные точки — страницы категорий, оранжевые — статьи с перекрёстными ссылками, а зелёные — с файлами для скачивания

Публикация статей

Админка Помощи задумывалась не для редакторов, поэтому за основу команда взяла визуальный редактор на контейнерах — как в Ноушене. Но он не умел работать в режиме исходного кода — HTML или маркдауна.

Необходимость настраивать оформление вручную ломала мой отработанный процесс: на других проектах я целиком копировал гугл-док и прогонял текст через Драйзер — самописный скрипт на регулярках. Скрипт вырезал инлайн-стили и служебные блоки, оставляя чистый HTML. Так я мог заряжать в админку по статье в минуту.

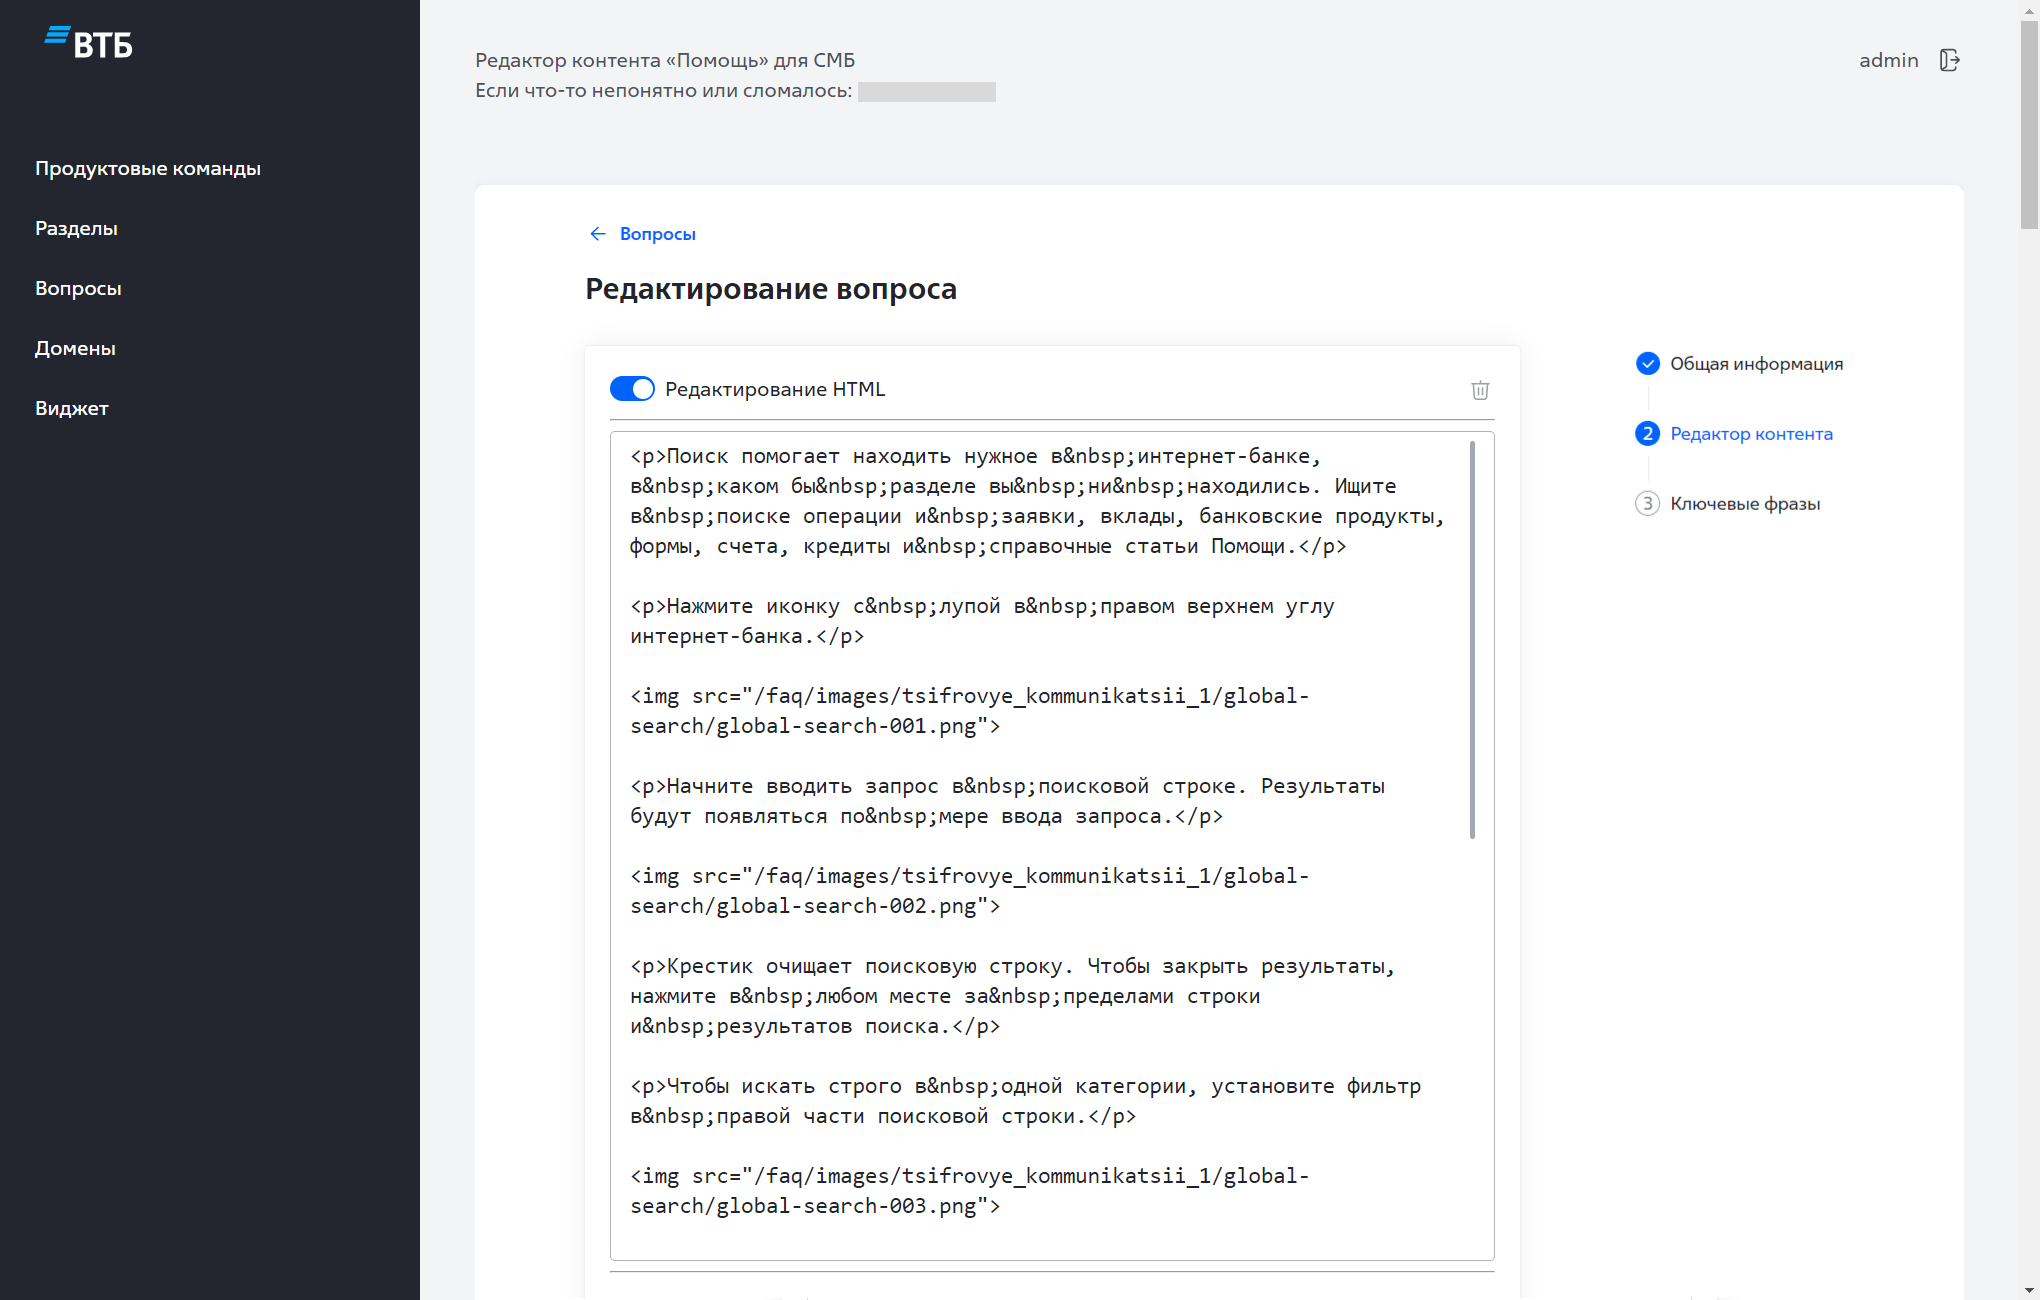
Менять редактор было поздно, но разработчики нашли остроумное решение: добавили переключатель, который скрывал все контейнеры и показывал поле для HTML-кода.

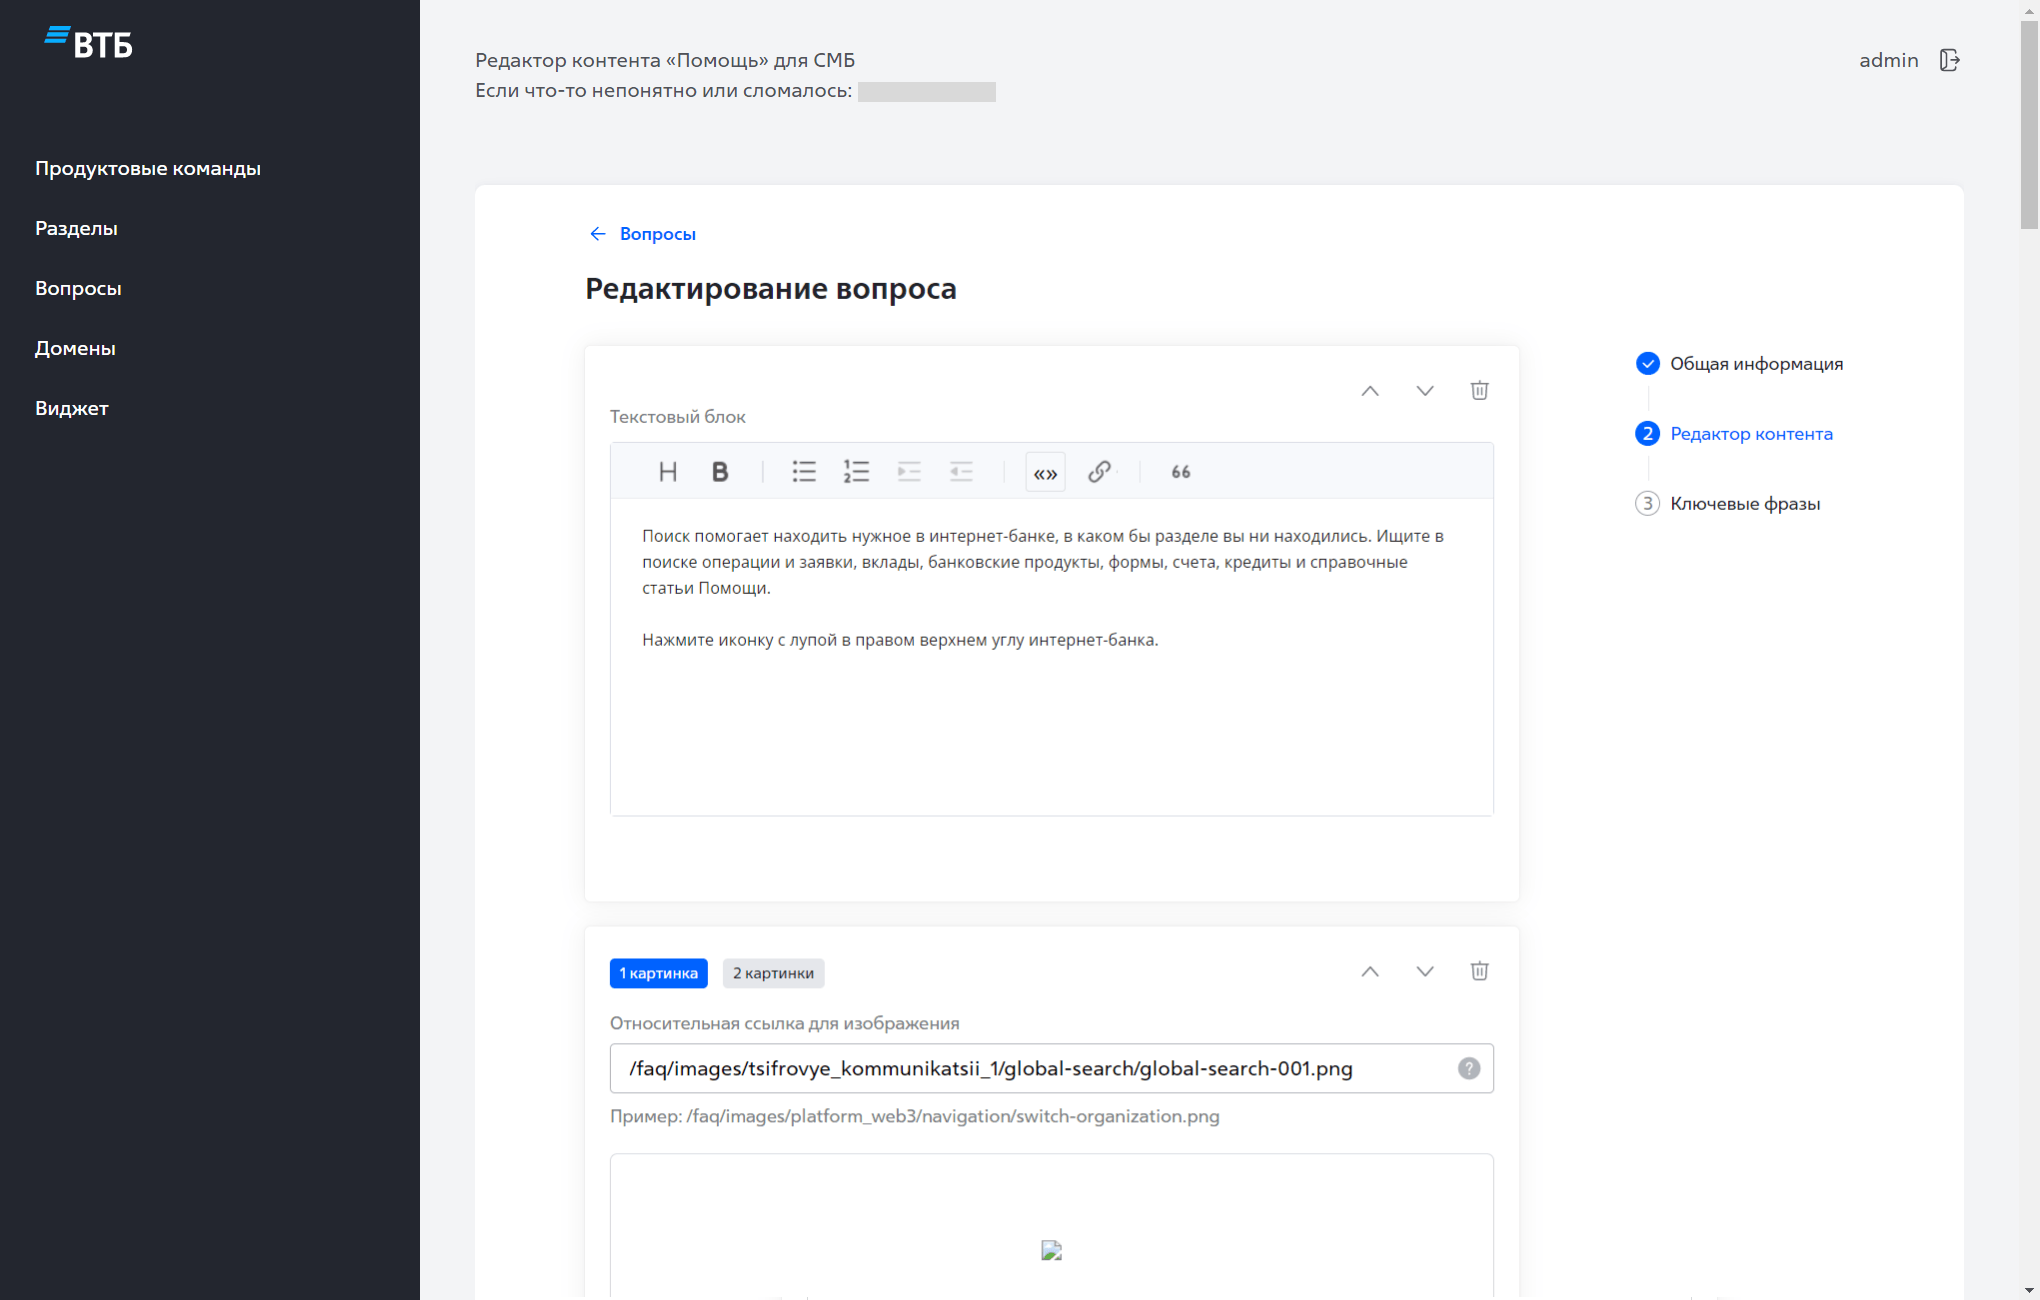
Редактирование статьи в обычном и экспертном режимах. В ранних версиях админки статья называлась вопросом, так уж вышло

Мы выбрали HTML, а не в маркдаун, чтобы как можно меньше переписывать админку. Я всё равно получал готовый код из гугл-дока и сразу типографил текст своими скриптами.

Ещё я поучаствовал в разработке админки: тестировал механики, писал текст интерфейса, подменял дизайнера, надоедал всем нормами типографики и спорил с бизнес-аналитиком из-за статусной модели :3

Работа с СУБО

Сначала в Помощи публиковались 10 команд, но позже их стало уже 35. Они постоянно что-то меняли, уследить за всем было невозможно. Поэтому мы договорились, что за актуальностью своих статей СУБО следят сами, а команда Помощи отвечает за подготовку и публикацию.

Процесс добавления новой статьи выглядел так:

  1. В СУБО назначали ответственного за процесс и обновляли макеты.
  2. Ответственный заполнял бриф на новую статью, в котором указывал тему, полезное действие, примерный план, ссылки на макеты и документацию.
  3. Я принимал заявку, изучал материалы и предметную область, задавал вопросы аналитикам и дизайнерам, просил показать продукт в работе.
  4. Собрав всю фактуру, я писал черновик и готовил иллюстрации по макетам.
  5. Ответственный вычитывал и комментировал черновик, я дописывал нужное, и всё повторялось, пока статья не была готова.
  6. Согласованную статью я добавлял в админку, помечал готовой к публикации и закрывал задачу.

Чтобы изменить уже опубликованную статью, ответственный просто правил копию исходника и передавал мне. А чтобы не тонуть в бюрократии, мелкие правки мы вносили без задачи в Джире, просто по переписке в мессенджере.

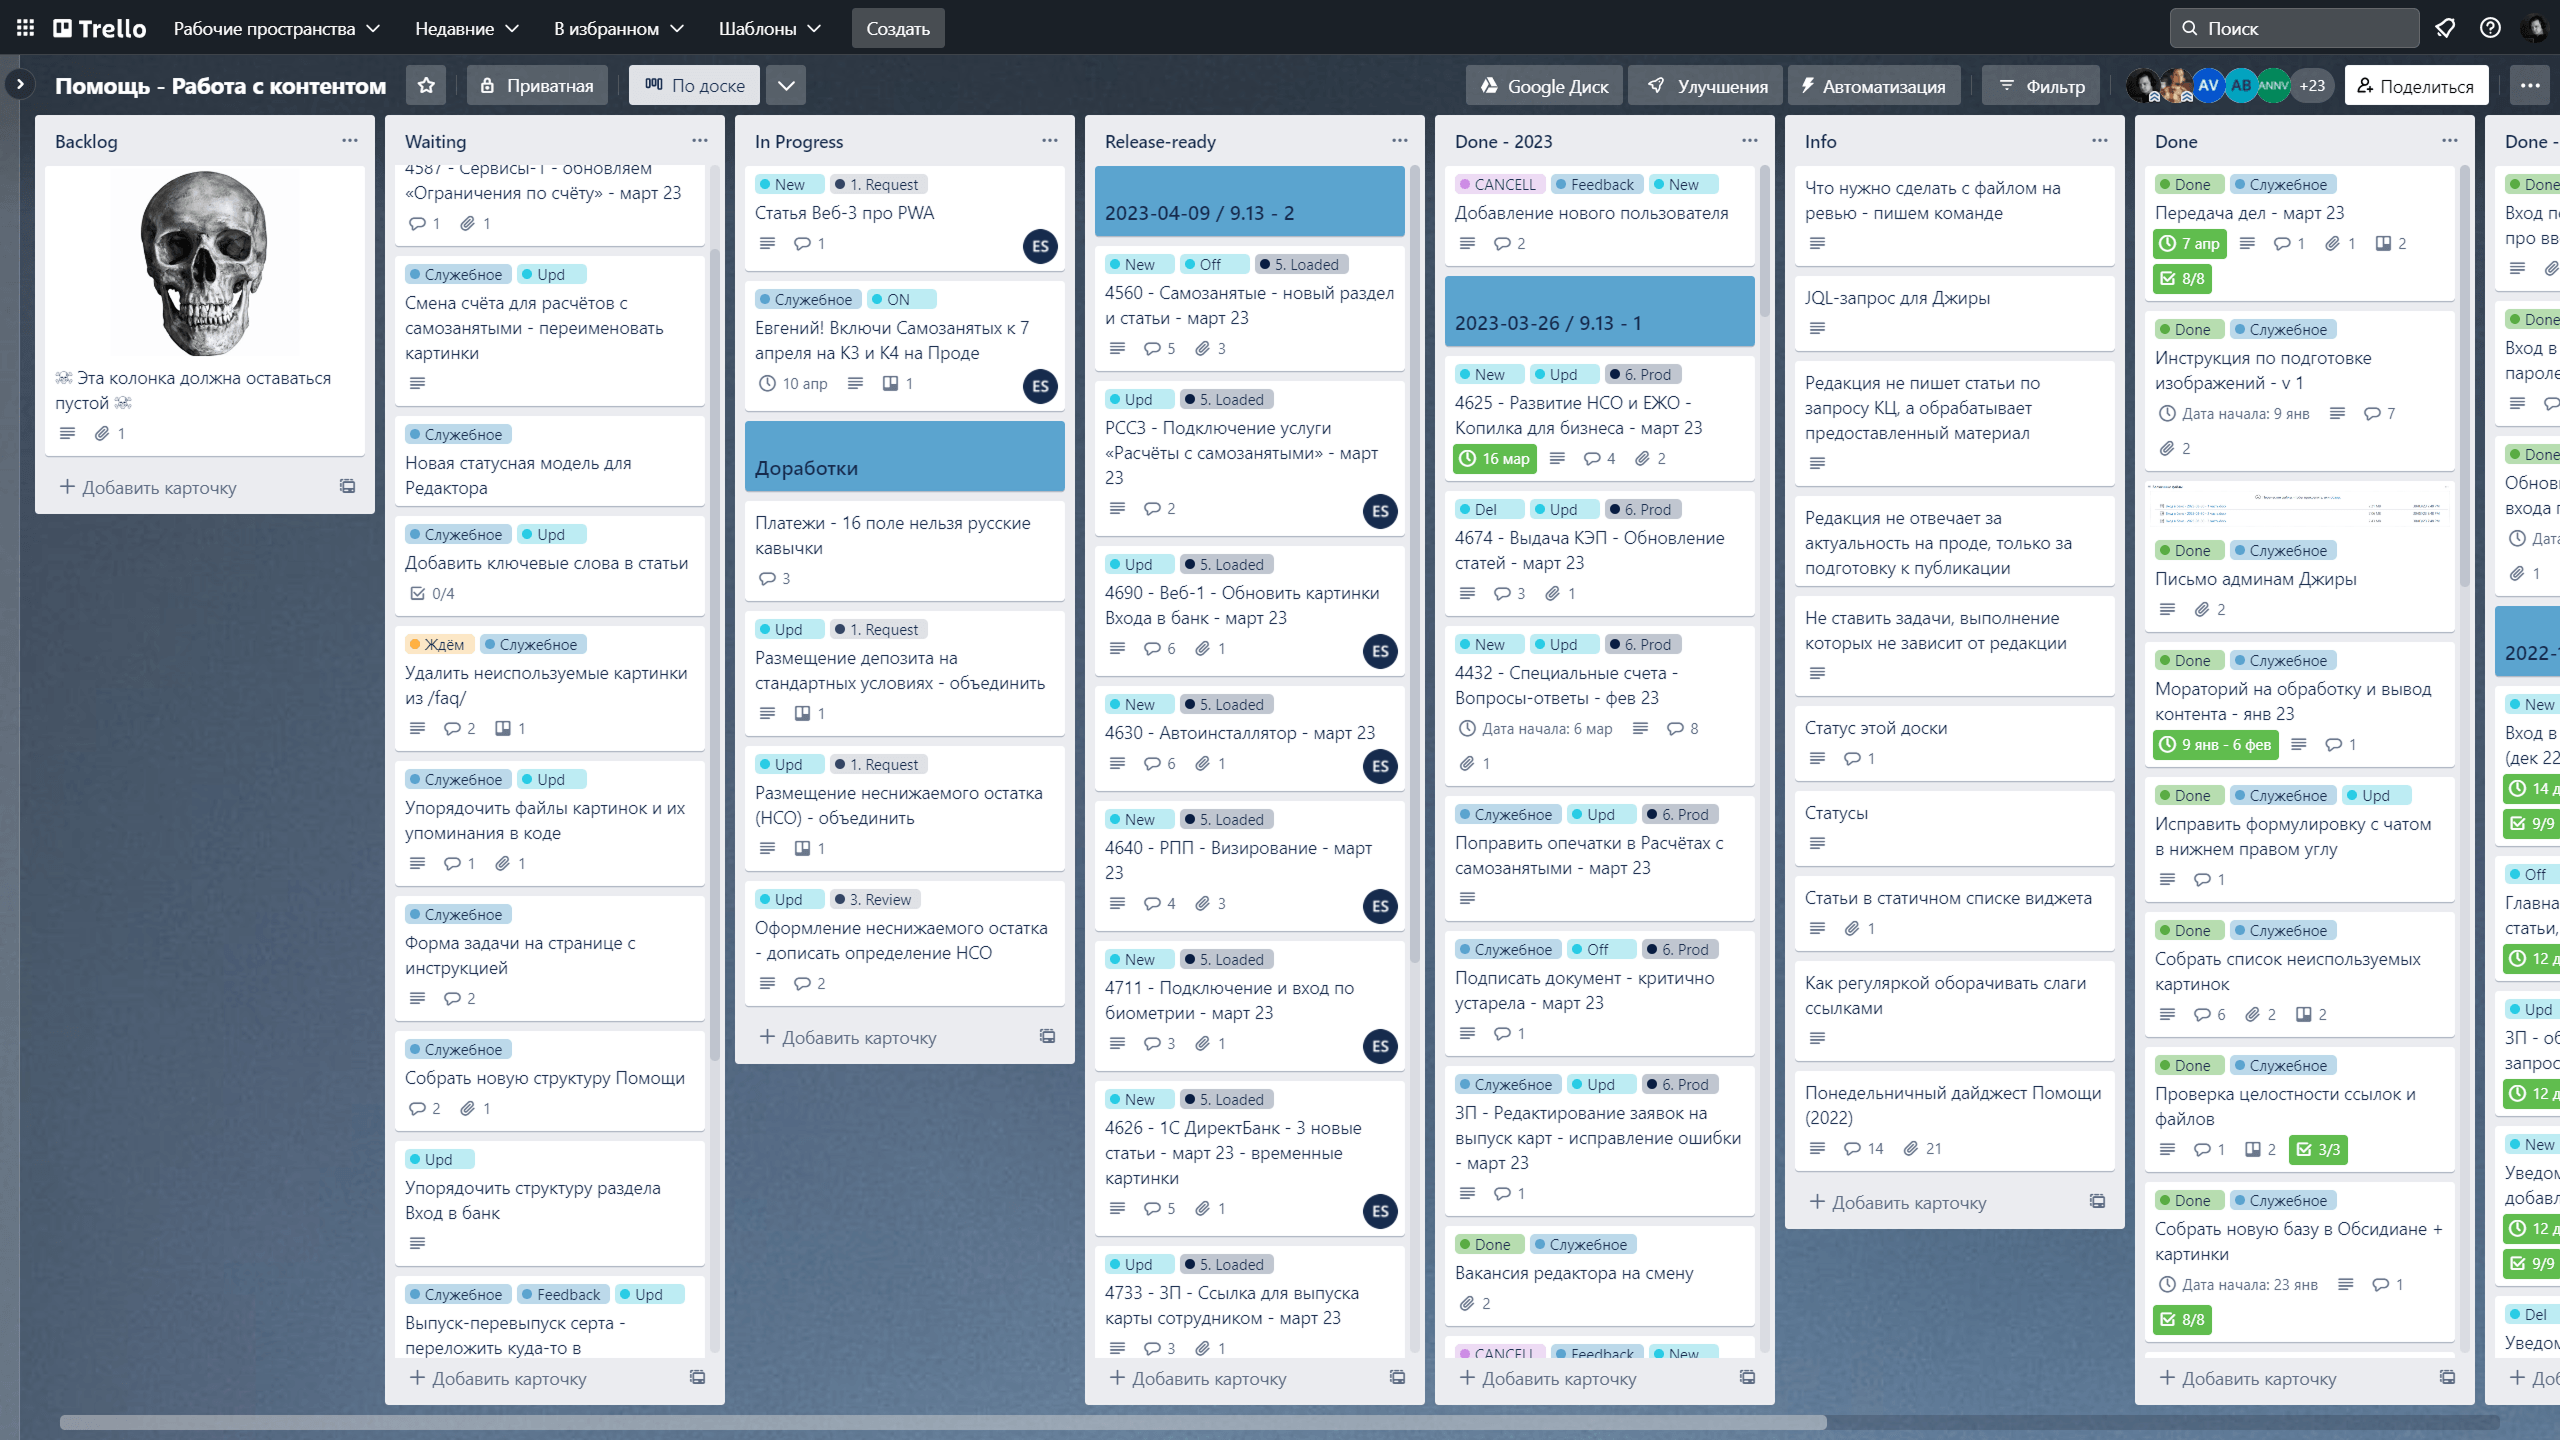
Задачи шли потоком, мы постоянно что-то правили, обновляли, поддерживали порядок и готовили пачки новых статей к релизам. Отслеживать всё в Джире не получалось, поэтому я завёл редакционный дашборд в Трелло.

Объём задачи в карточке мог быть любым, от мелкой правки до десятка статей

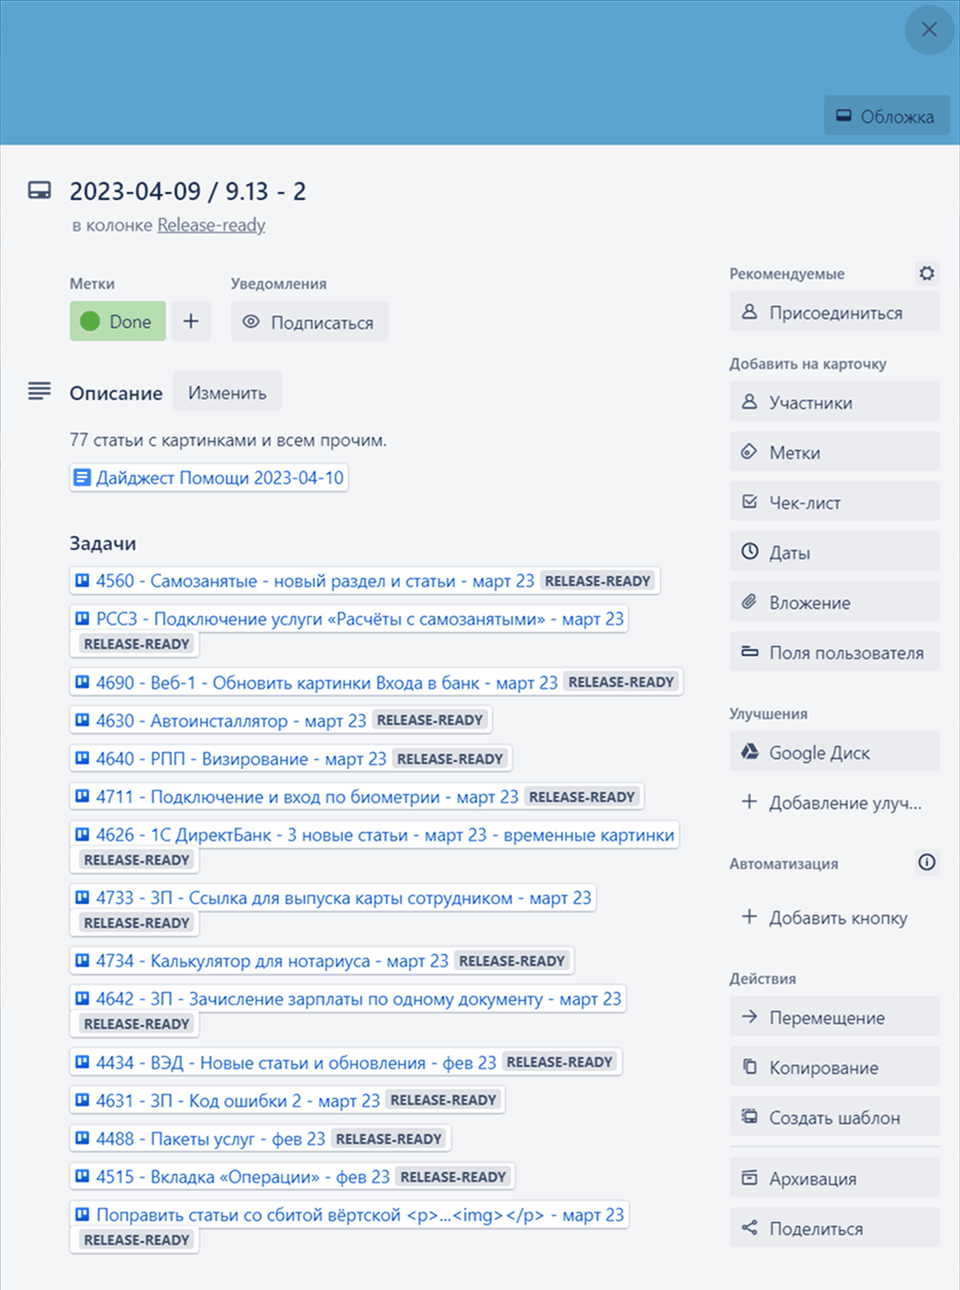
Карточка с задачами типичного релиза выглядела так:

Обновляем 77 статей: добавляем новые, объединяем старые, правим опечатки, заменяем иллюстрации со старым интерфейсом

Итоги

Настроив процессы, мы занялись обычной текучкой: писали новые статьи, обновляли старые, изучали обратную связь от пользователей и операторов горячей линии, следили за обращениями в поддержку и метриками сервиса.

Наша команда занималась и другими внутренними сервисами, поэтому мы смогли включить статьи Помощи в глобальный поиск, базу знаний поддержки, чат-бота и контекстную справку в интерфейсе. Нашему руководителю Александру удалось совершить дипломатическое чудо и отвязать публикацию статей от общего релизного цикла, и мы стали обновлять статьи по мере изменений в продуктах, без очередей и предрелизной спешки.

Но статей становилось всё больше, а задач на UX-редактуру не прибавлялось, так что я решил заняться Умным домом в МТС. А чтобы проект было легче передать, собрал материалы, записал скринкасты с основными процессами и составил вакансию редактора Помощи.

К сожалению, вскоре в компании изменилась политика информационной безопасности, внешние облачные сервисы запретили и отбить гугл-доки не удалось. Исходники статей переехали в корпоративную вики, и процессы вновь пришлось менять.

Благодарности

Спасибо команде Помощи за понимание, поддержку и вовлечённость. Вы с готовностью вникали во все мои идеи, хоть иногда я не особо выбирал выражения. С вами я получил бесценный опыт — как быть частью команды и находить продуктивное решение.

«Хороших выходных. И ведите себя плохо!» ©

Делаем сноски на HTML регулярками

Регулярные выражения — мощный инструмент поиска и замены фрагментов текста. Редактору полезно ими владеть, чтобы при случае не менять что-то руками, а один раз написать умный шаблон. Синтаксис регулярных выражений подробно описан в интернете, поэтому мы сразу перейдём к примеру.

В статье про нейронные сети у меня набралось десять примечаний, которые я решил оформить ссылками, как в Википедии: знак сноски в верхнем регистре со ссылкой на примечание и примечание в конце статьи со ссылкой на сноску.

Было бы лучше, если бы примечание вплывало при наведении на знак сноски, как в Обсидиане, но Эгея не поддерживает сноски вообще. Чтобы не лезть в код движка, я делаю их на чистом HTML, без JS и прочих хитростей

Текст статьи жил в Обсидиане, поэтому ссылки и сноски оформлены в маркдауне:

Текст со сноской[^1]
...
[^1]: Текст примечания на отдельной строке

Эти штуки в скобочках предстояло превратить в HTML:

Текст со сноской <sup><a href="all/ai-talks/#t1" name="n1">[1]</a></sup>
...
<a name="t1"></a>
1. Текст примечания <a href="all/ai-talks/#n1">↩︎</a>

Клик на знак сноски прокручивает страницу до тега <А> с именем «t1», а клик по стрелке — на тег <А> с именем «n1». Из-за особенностей движка в адрес ссылки «href=» приходится добавлять часть адреса страницы. Ссылка-якорь с именем примечания стоит на отдельной строке, чтобы окно браузера прокручивалось ровно до начала абзаца.

Чтобы пройтись по всему тексту и поменять маркдаун на HTML, нужно найти повторяющиеся фрагменты и написать на их основе шаблоны поиска и замены. Фрагменты у нас такие:

[^n] — знак сноски в сплошном тексте
[^n]: Какой-то текст — примечание на отдельной строке

Начнём со строки поиска знака сноски.

n — порядковый номер примечания, всего их десять. Значит, нам нужна регулярка, которая будет искать какое-то число от 1 до 10 в квадратных скобках c ^ в любом месте текста. Получится так:

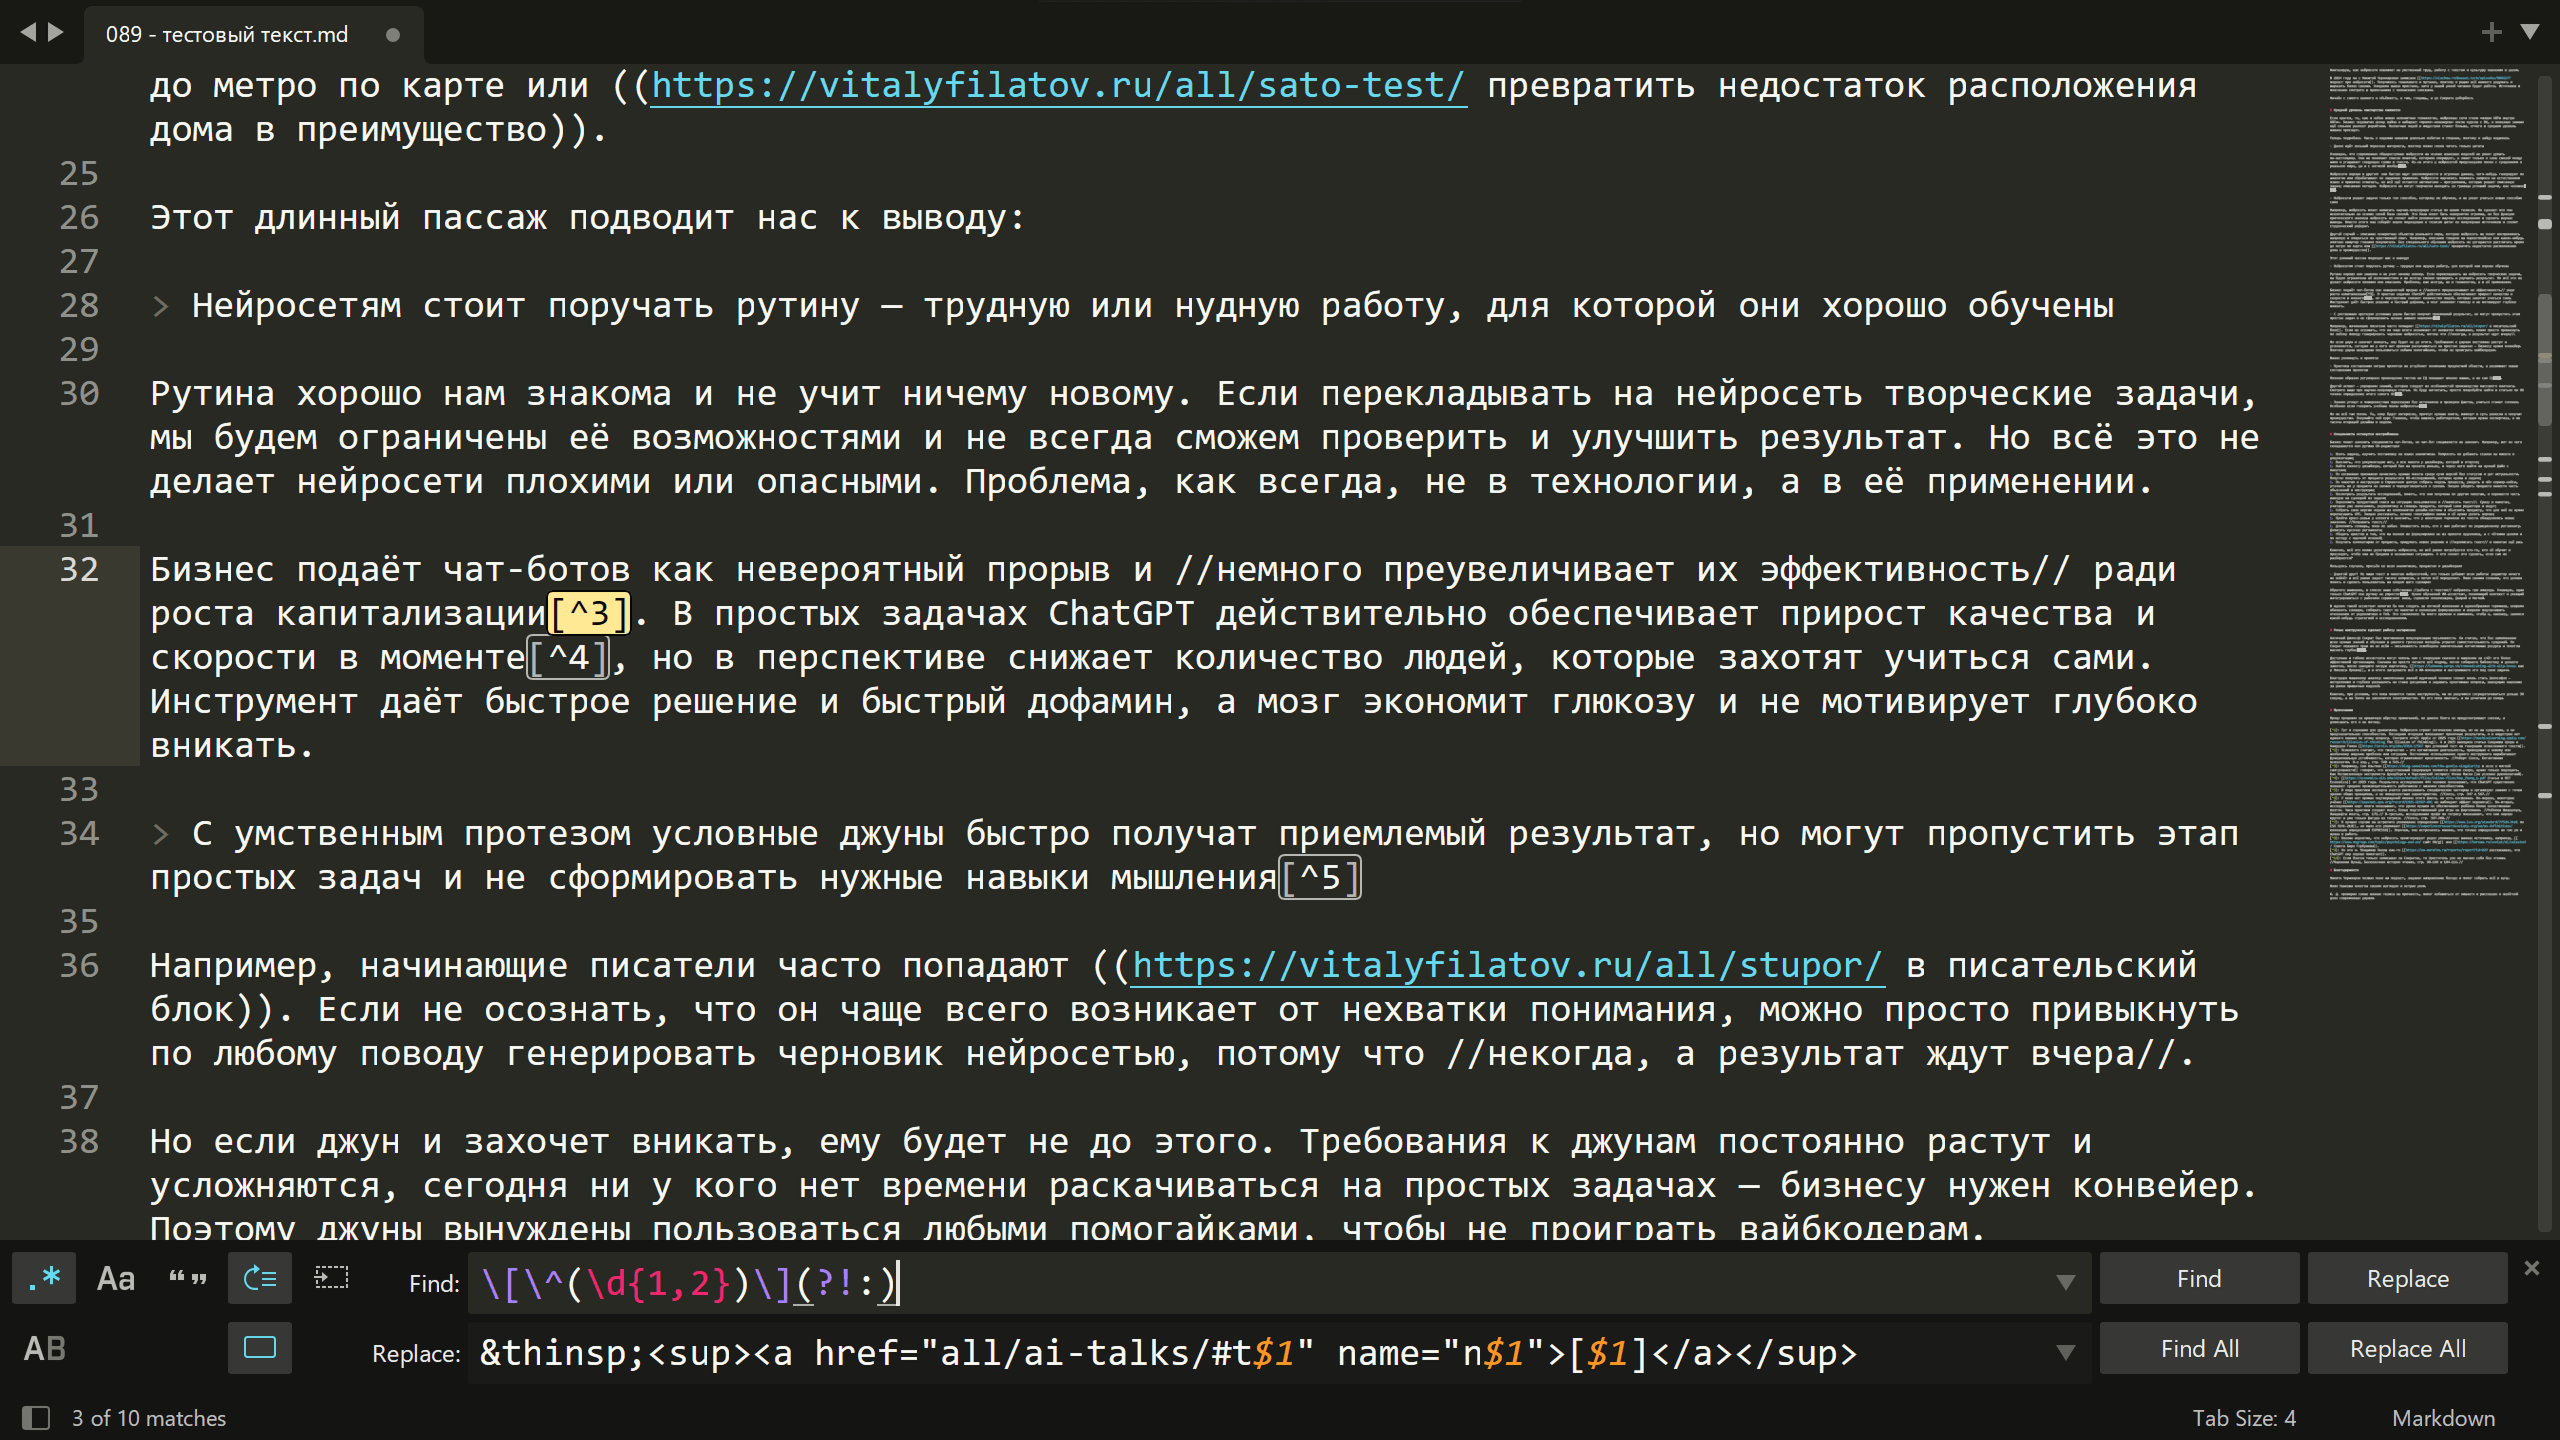
\[\^(\d{1,2})\](?!:)

Квадратные скобки и ^ — служебные символы, поэтому добавляем перед ними обратный слеш. А перед d — чтобы искать не саму букву, а символ любой цифры. В фигурных скобках указываем, что ищем 1 или 2 цифры. Круглые скобки сохраняют фрагмент строки в переменную — скобочную группу. В конце идёт указание, что строка не должна заканчиваться двоеточием. Это не совсем корректно, ведь знак сноски может стоять где угодно. Но для примера нужна регулярка попроще, так что просто убедимся, что в тексте такого нет.

Теперь напишем строку замены:

&thinsp;<sup><a href="all/ai-talks/#t$1" name="n$1">[$1]</a></sup>

Перед знаком ставим &thinsp; — HTML-код тонкого пробела, чтобы знак сноски не слеплялся со словом слева. $1 — переменная, в которой будет число из знака сноски, от 1 до 10. Единица после $ означает порядковый номер скобочной группы. В этой регулярке она одна, но для обработки примечаний нам потребуются уже две.

Теперь скопируем текст статьи из Обсидиана в Sublime text, откроем режим поиска и замены (Ctrl + H), включим регулярные выражения (Alt + R) и выполним первый набор регулярок.

Найденные регуляркой фрагменты выделены рамкой

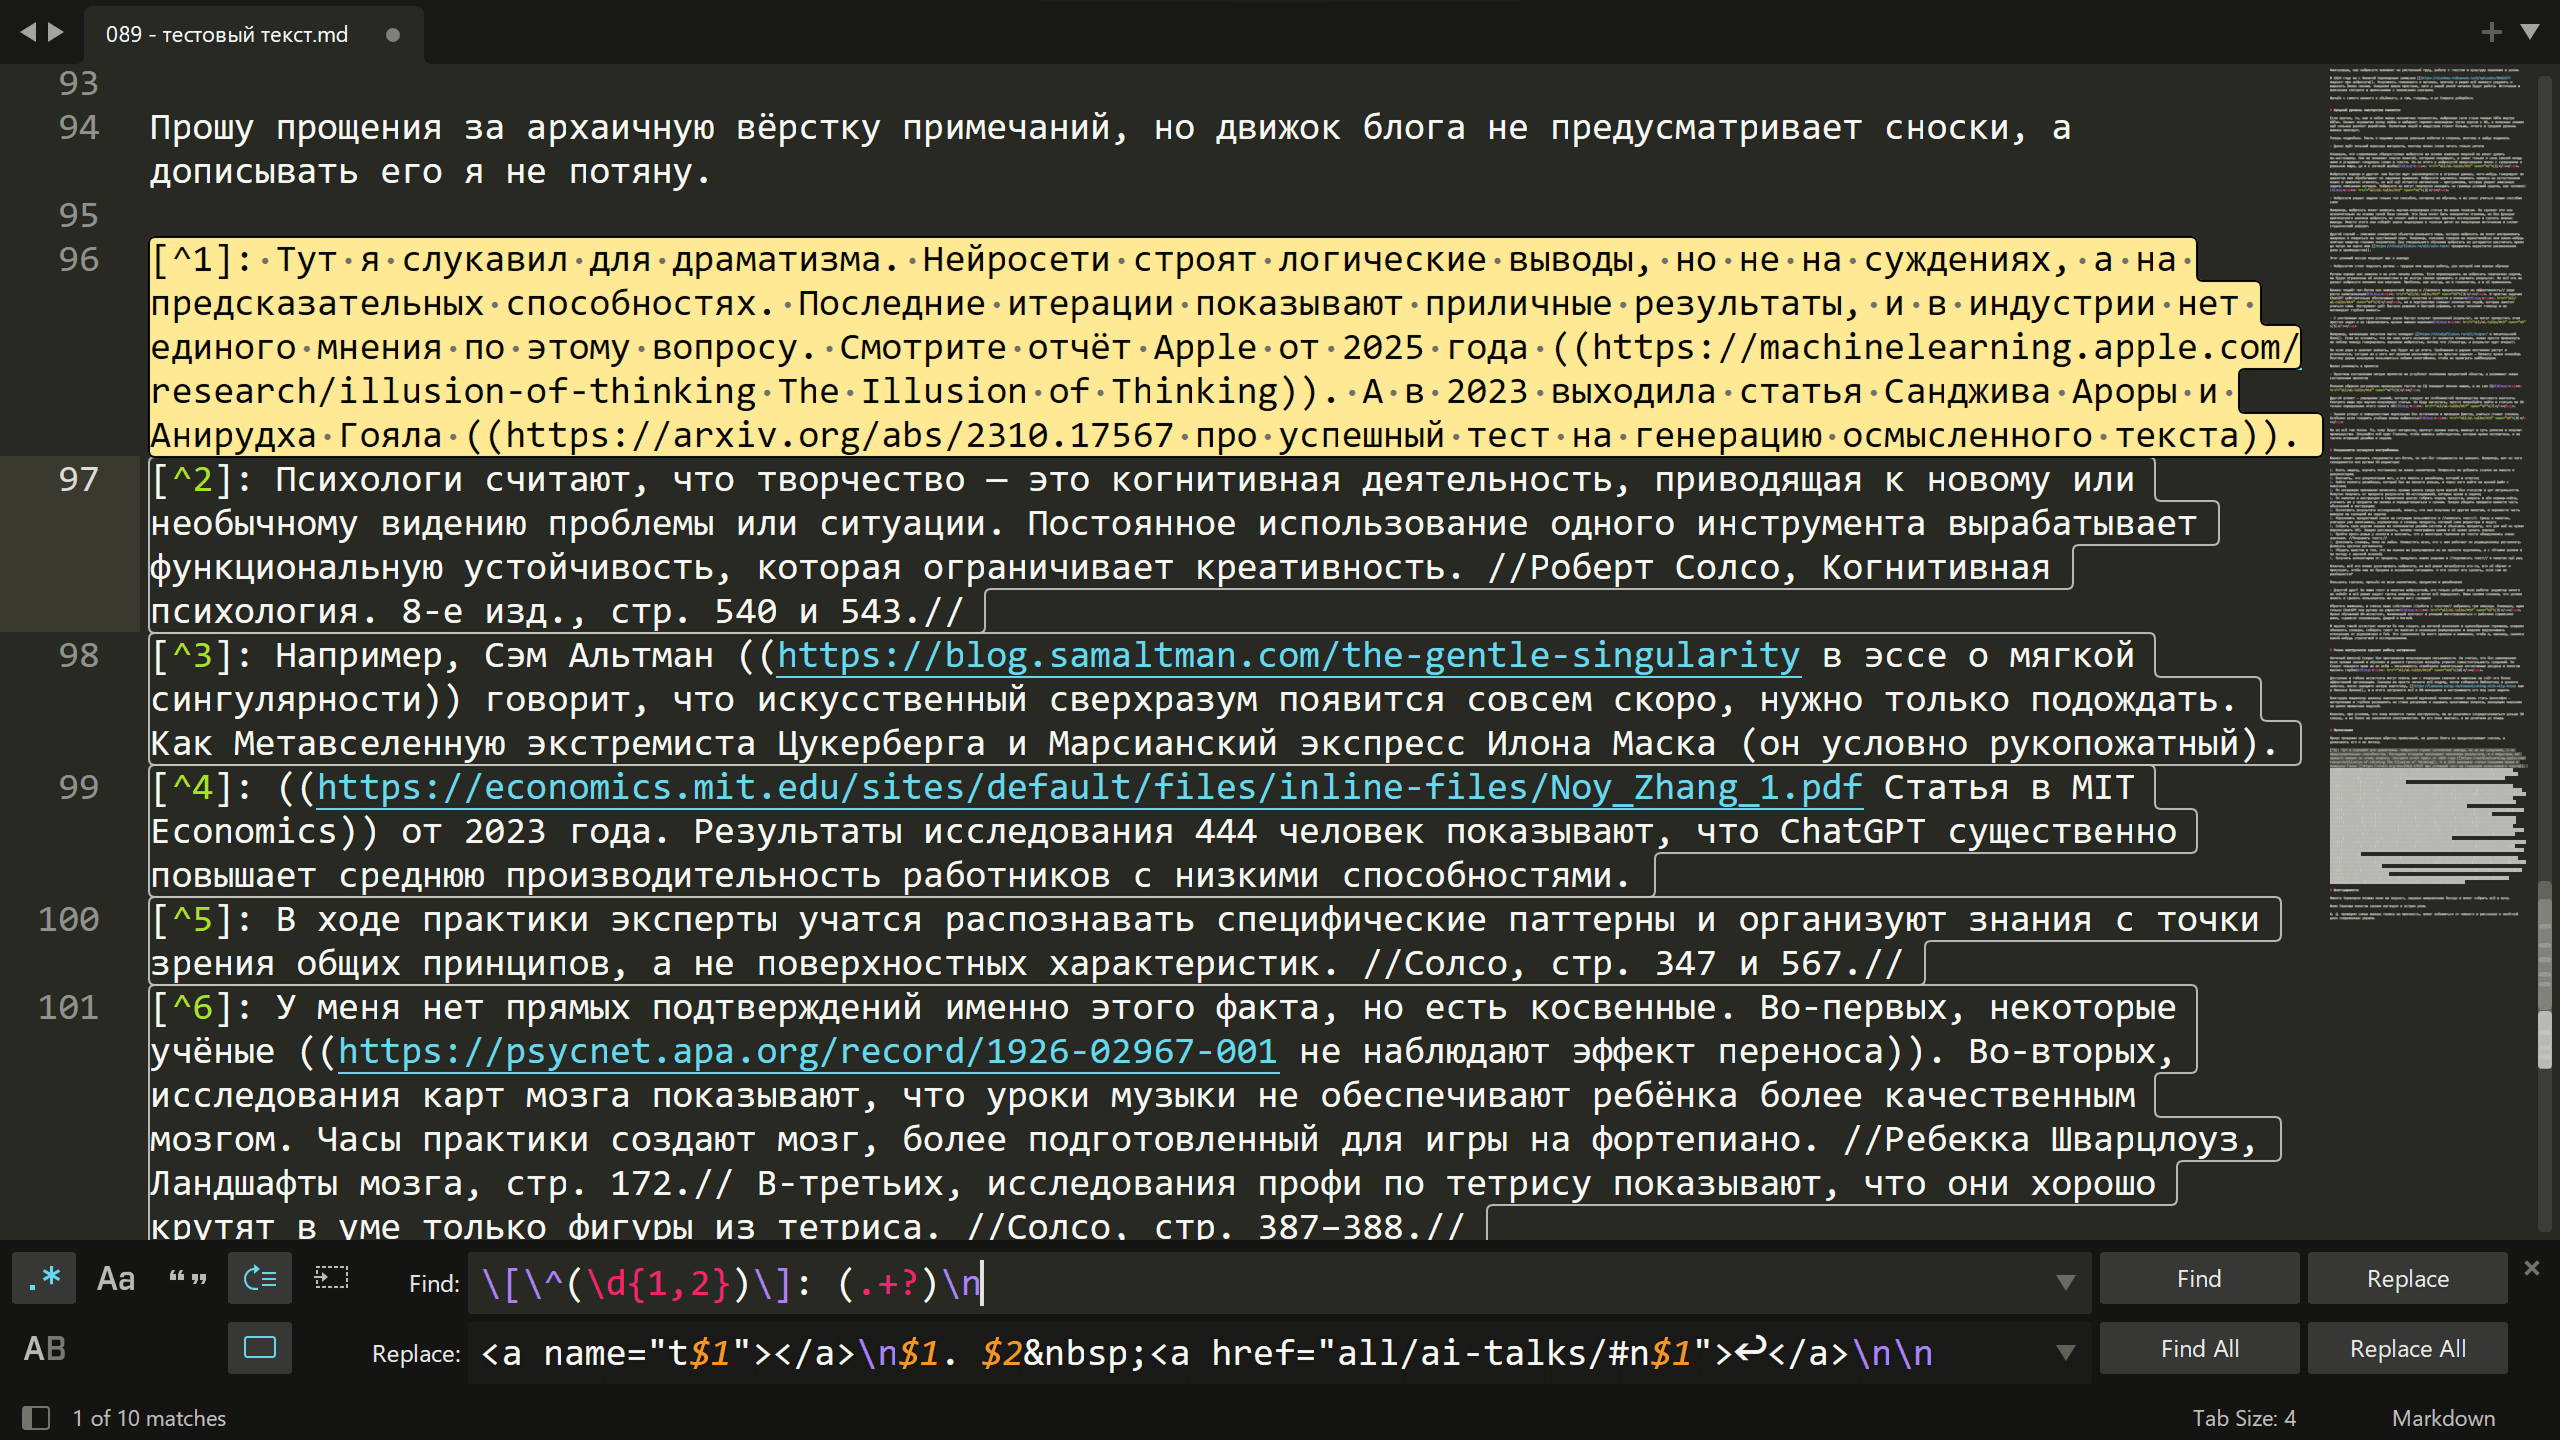
Теперь сами примечания. Найдём их в тексте:

\[\^(\d{1,2})\]: (.+?)\n

Первую часть вы уже видели, но теперь мы не исключаем двоеточие. Потом идёт любой текст. Точка означает «любой символ, кроме переноса строки», а «+?» говорит брать символы до первого символа правее. В нашем случае это конец строки \n.

Напишем строку замены:

<a name="t$1"></a>\n$1. $2&nbsp;<a href="all/ai-talks/#n$1">↩︎</a>\n\n

Как видите, порядковый номер сноски $1 удачно стал частью ссылок и порядковым номером примечания, а текст примечания из скобочной группы $2 вставится между номером с точкой и ссылкой на знак сноски. &nbsp; — знак неразрывного пробела, чтобы стрелка не повисала на следующей строке.

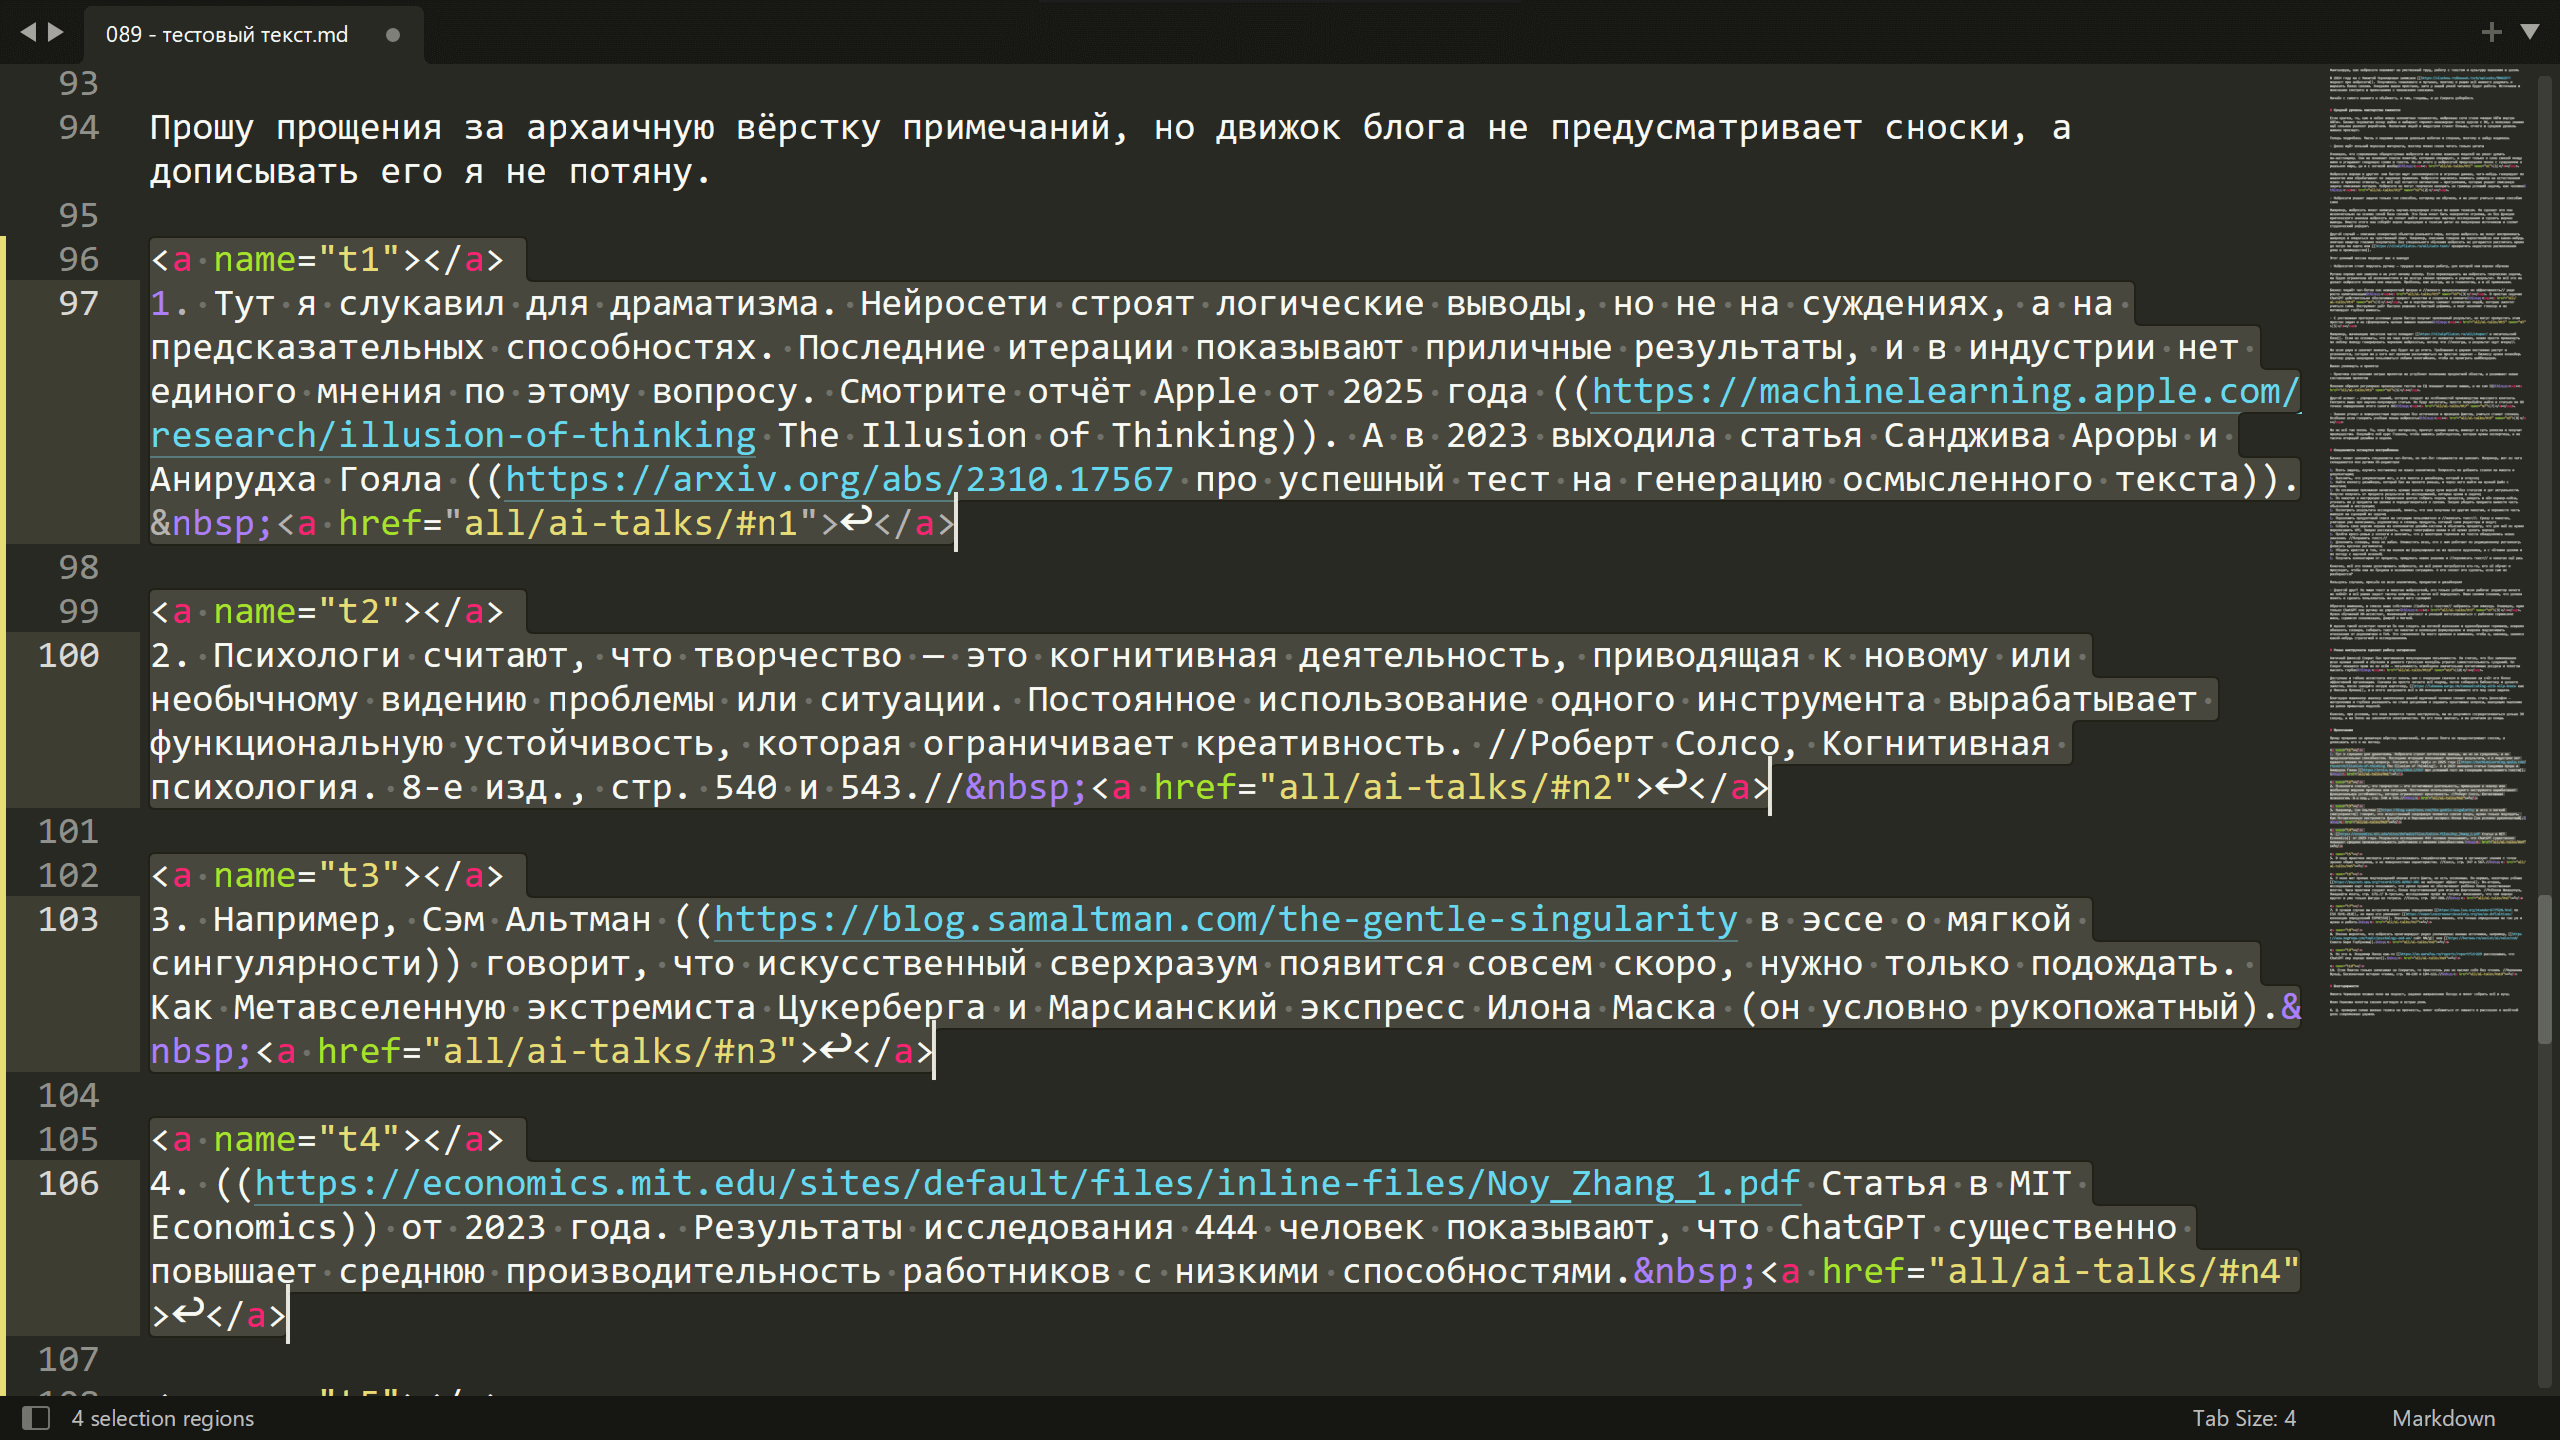
Вставим строки в редактор и выполним замену:

Все сноски превратились в HTML

Результат можно посмотреть в коде статьи.

Где и как учиться регуляркам

Регулярки в JavaScript — приятный сайт на русском

Regular-Expressions.info — сайт про регулярки на английском

RegExr — гибкий отладчик регулярок. Можно устанавливать разные параметры поиска (флаги), смотреть, что попадает в скобочные группы, и тестировать строку замены

Как нейросети могут изменить работу UX-редактора

Фантазирую, как нейросети повлияют на умственный труд, работу с текстом и культуру мышления в целом.

В 2024 году мы с Никитой Чернояровым записали подкаст про нейросети. Получилось тяжеловато и путанно, поэтому я решил всё немного додумать и выразить более связно. Ожидаемо вышла простыня, зато у вашей умной читалки будет работа. Источники и пояснения смотрите в примечаниях с пижонскими сносками.

Начнём с самого важного и объёмного, а там, глядишь, и до Сократа доберёмся.

Средний уровень мастерства снизится

Если кратко, то, как и любая новая непонятная технология, нейронные сети стали «новым АйТи внутри АйТи». Бизнес подхватил волну хайпа и набирает «промпт-инженеров» после курсов с ВК, а полезные знания ещё сильнее размоет рерайтами. Неопытных людей в индустрии станет больше, отчего в среднем уровень навыка просядет.

Теперь подробнее. Мысль о падении навыков довольно избитая и спорная, поэтому я зайду издалека.

Далее идёт вольный пересказ интернета, поэтому можно смело читать только цитаты

Очевидно, что современные общедоступные нейросети на основе языковых моделей не умеют думать по-настоящему. Они не понимают смысла понятий, которыми оперируют, а знают только о силе связей между ними и угадывают следующее слово в тексте. Из-за этого у нейросетей предсказуемо плохо с суждениями о реальном мире, да и с логикой вообще [1].

Нейросети хороши в другом: они быстро ищут закономерности в огромных данных, чего-нибудь генерируют по аналогии или обрабатывают по заданным правилам. Нейросети научились понимать запросы на естественном языке и прилично отвечать, но всё ещё остаются автоматами — программами, которые решают описанную задачу описанным методом. Нейросети не могут творчески выходить за границы условий задачи, как человек [2].

Нейросети решают задачи только тем способом, которому их обучили, и не умеют учиться новым способам сами

Например, нейросеть может написать научно-популярную статью по вашим тезисам. Но сделает это она исключительно на основе своей базы связей. Эта база может быть невероятно огромна, но без функции критического анализа нейросеть не сможет найти релевантные научные исследования и сделать верные выводы. Вместо этого она соберёт ворох подходящих к тезисам цитат из популярных источников и слепит студенческий реферат.

Другой случай — описание конкретных объектов реального мира, которые нейросеть не может воспринимать напрямую и опираться на чувственный опыт. Например, описание товаров на маркетплейсах или каких-нибудь элитных квартир глазами покупателя. Без специального обучения нейросеть не догадается рассчитать время до метро по карте или превратить недостаток расположения дома в преимущество.

Этот длинный пассаж подводит нас к выводу:

Нейросетям стоит поручать рутину — трудную или нудную работу, для которой они хорошо обучены

Рутина хорошо нам знакома и не учит ничему новому. Если перекладывать на нейросеть творческие задачи, мы будем ограничены её возможностями и не всегда сможем проверить и улучшить результат. Но всё это не делает нейросети плохими или опасными. Проблема, как всегда, не в технологии, а в её применении.

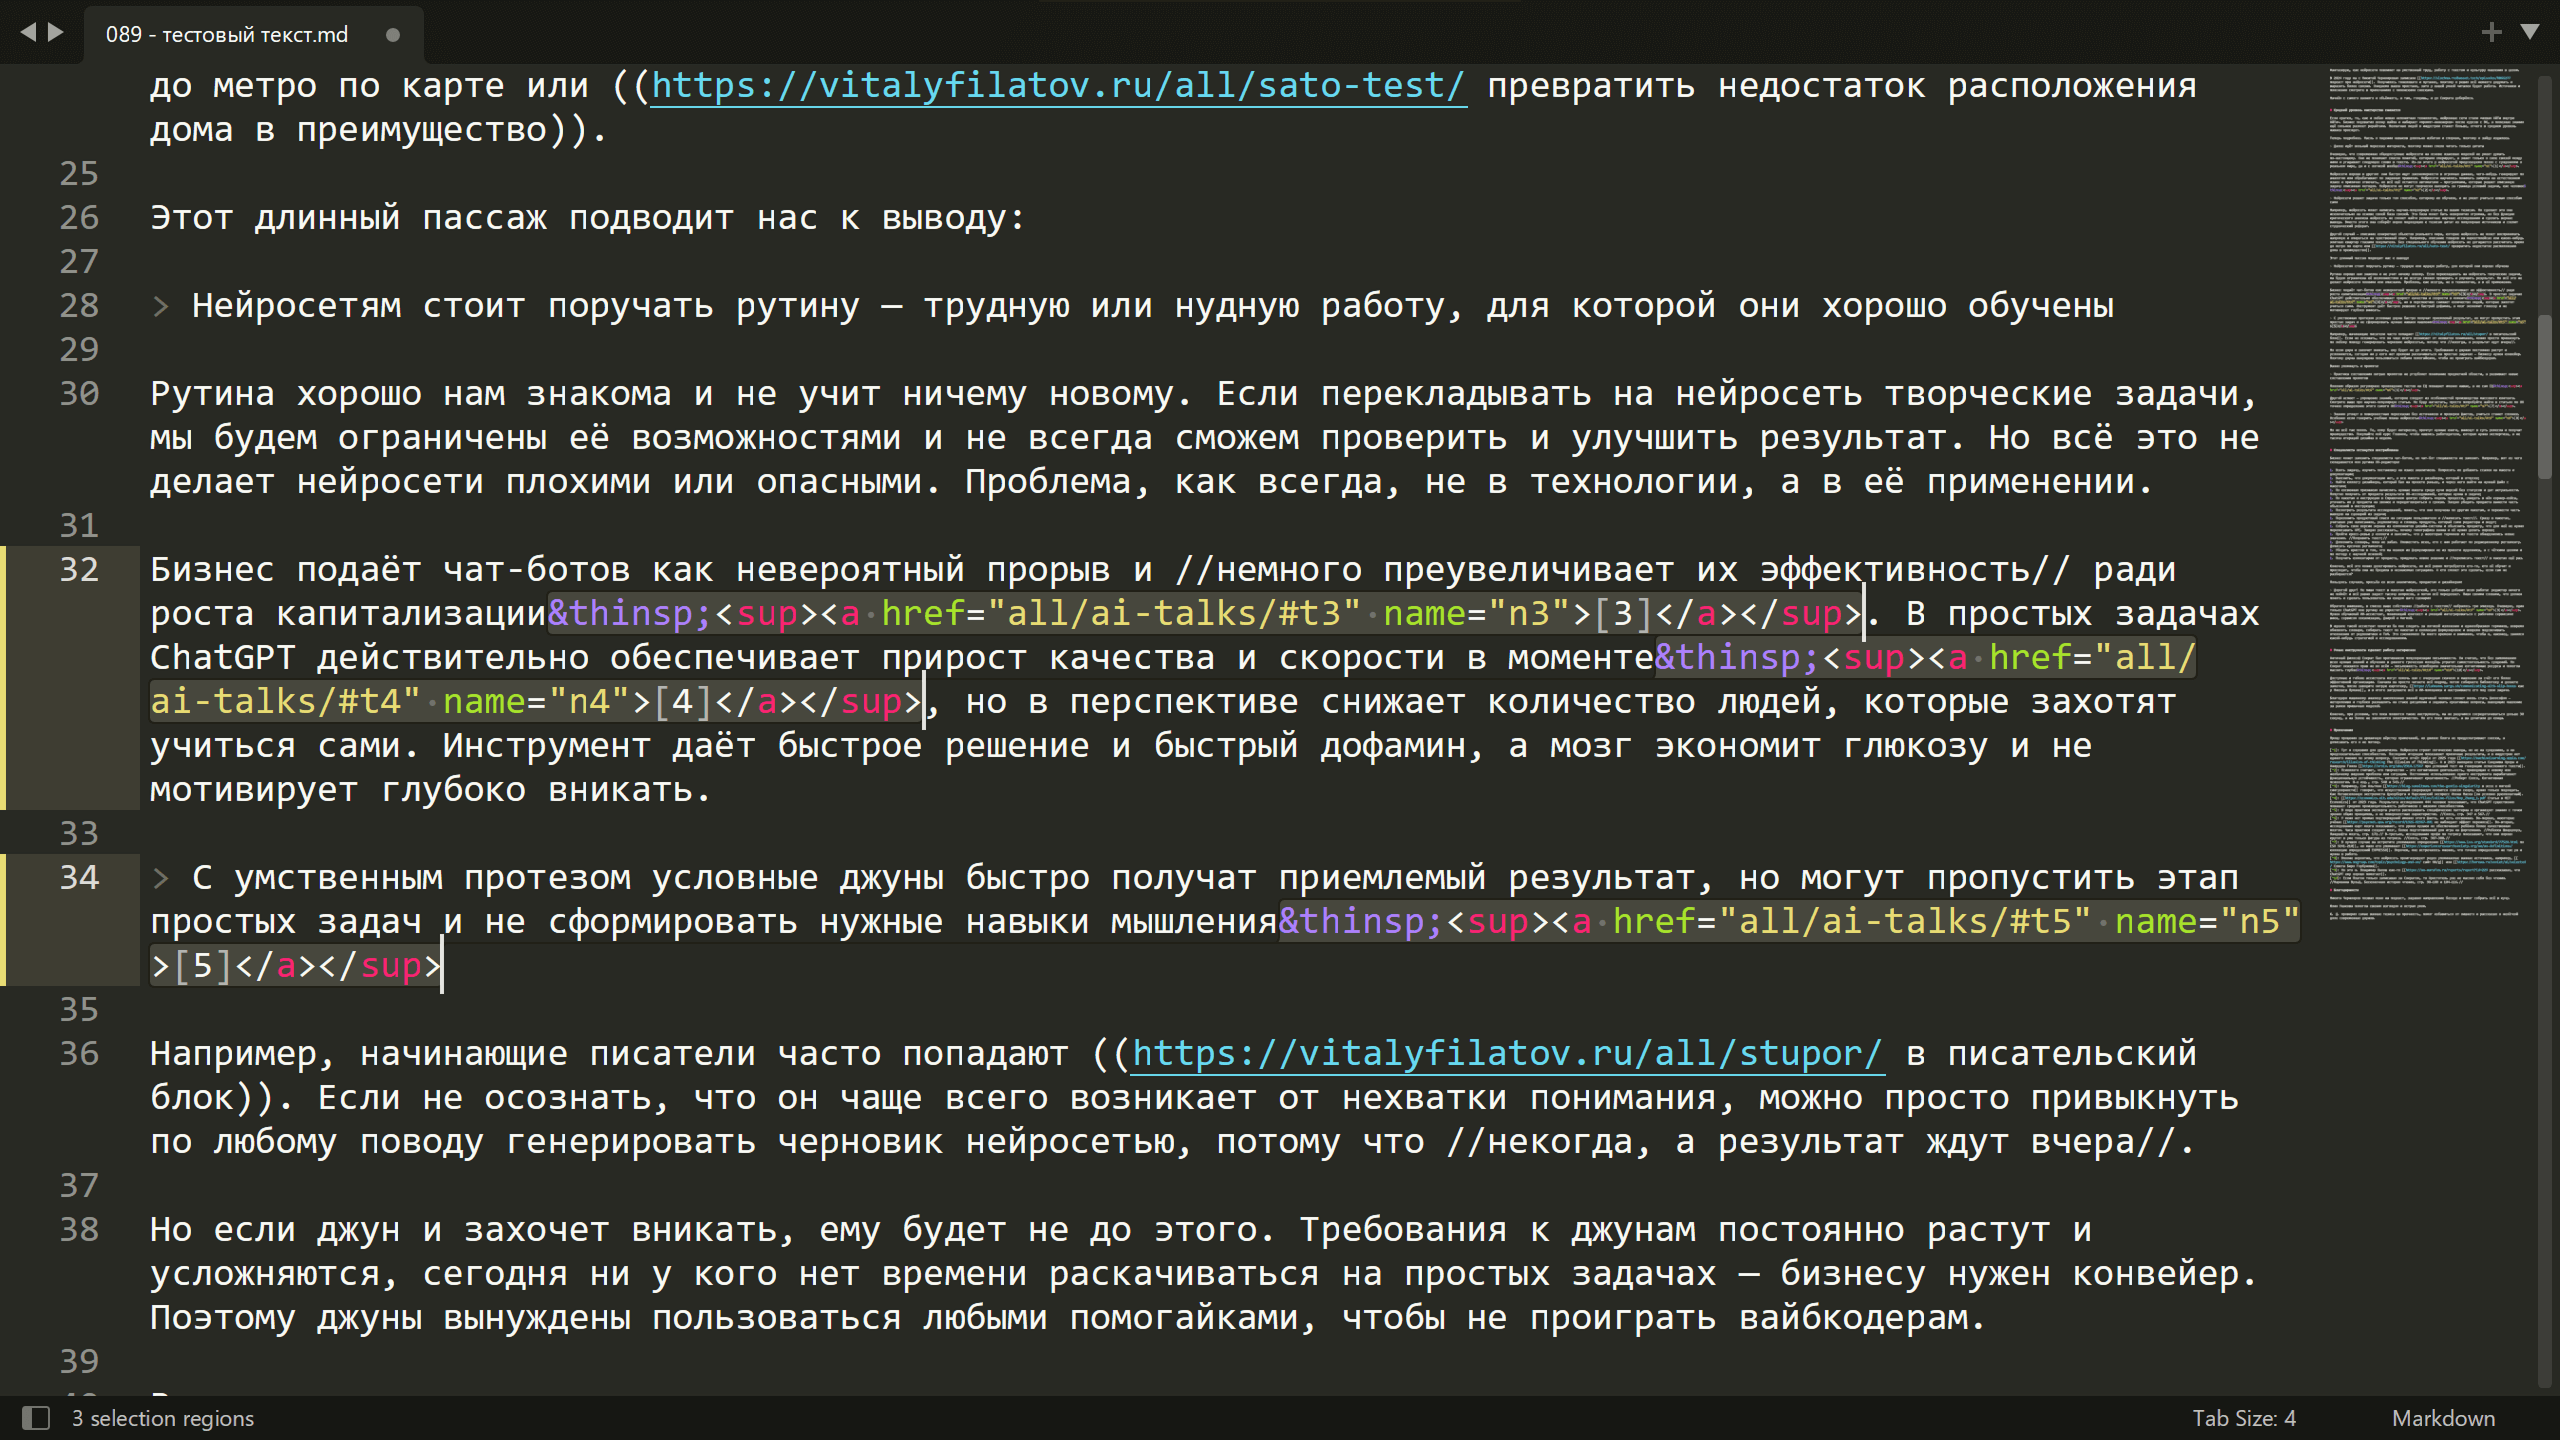
Бизнес подаёт чат-ботов как невероятный прорыв и немного преувеличивает их эффективность ради роста капитализации [3]. В простых задачах ChatGPT действительно обеспечивает прирост качества и скорости в моменте [4], но в перспективе снижает количество людей, которые захотят учиться сами. Инструмент даёт быстрое решение и вознаграждение, а мозг экономит глюкозу и не мотивирует глубоко вникать.

С умственным протезом условные джуны быстро получат приемлемый результат, но могут пропустить этап простых задач и не сформировать нужные навыки мышления [5]

Например, начинающие писатели часто попадают в писательский блок. Если не осознать, что он чаще всего возникает от нехватки понимания, можно просто привыкнуть по любому поводу генерировать черновик нейросетью, потому что некогда, а результат ждут вчера.

Но если джун и захочет вникать, ему будет не до этого. Требования к джунам постоянно растут и усложняются, сегодня ни у кого нет времени раскачиваться на простых задачах — бизнесу нужен конвейер. Поэтому джуны вынуждены пользоваться любыми помогайками, чтобы не проиграть вайбкодерам.

Важно упомянуть и промпты:

Практика составления хитрых промптов не углубляет понимание предметной области, а развивает навык составления промптов

Похожим образом регулярное прохождение тестов на IQ повышает именно навык, а не сам IQ [6].

Другой аспект — упрощение знаний, которое следует из особенностей производства массового контента. Смотрите выше про научно-популярную статью. Не буду нагнетать, просто попробуйте найти в статьях по UX точное определение этого самого UX [7].

Знания утонут в поверхностных пересказах без источников и проверки фактов, учиться станет сложнее. Особенно если генерить учебные планы нейросетью [8]

Но не всё так плохо. Те, кому будет интересно, прочтут нужные книги, вникнут в суть ремесла и получат преимущество. Покупайте мой курс Главное, чтобы нашлись работодатели, которым нужна экспертиза, а не тысяча итераций дизайна в неделю.

Специалисты останутся востребованы

Бизнес может заменить специалиста чат-ботом, но чат-бот специалиста не заменит. Например, вот из чего складывается моя рутина UX-редактора:

  1. Взять задачу, изучить постановку на языке аналитиков. Попросить их добавить ссылки на макеты и документацию;
  2. Выяснить, что документации нет, а все макеты у дизайнера, который в отпуске;
  3. Найти коллегу дизайнера, который был на проекте раньше, и через него выйти на нужный файл с макетами;
  4. По косвенным признакам вычислить нужные макеты среди кучи версий без статусов и дат актуальности. Попутно получить от продакта результаты UX-исследований, которые нужны в задаче;
  5. По макетам и инструкции в Справочном центре собрать модель процесса, увидеть в нём корнер-кейсы, уточнить их у продакта на звонке и передоговориться о сроках. Заодно убедить продакта вынести часть объяснений в инструкцию;
  6. Посмотреть результаты исследований, понять, что они получены по другим макетам, и перенести часть выводов на сценарий из задачи;
  7. Переложить продуктовый смысл на ситуацию пользователя и написать текст. Сразу в макетах, учитывая уже написанное, редполитику и словарь продукта, который сами редакторы и ведут;
  8. Собрать свою версию экрана из компонентов дизайн-системы и объяснить продакту, что для неё не нужно переписывать API. Заодно рассказать, почему типографика важна и её нужно делать хорошо;
  9. Пройти кросс-ревью у коллеги и выяснить, что у некоторых терминов из текста обнаружились новые значения. Поправить текст;
  10. Дополнить словарь, пока не забыл. Оповестить всех, кто с ним работает по редакционному регламенту. Дописать кусочек регламента;
  11. Убедить юристов в том, что мы меняем их формулировки не из прихоти художника, а с чёткими целями и по методу с научной основой;
  12. Получить комментарии от продакта, придумать новое решение и переписать текст в макетах ещё раз.

Конечно, всё это можно делегировать нейросети, но всё равно потребуется кто-то, кто её обучит и проследит, чтобы она не бредила в незнакомых ситуациях. А кто сможет это сделать, если сам не разбирается?

Пользуясь случаем, просьба ко всем аналитикам, продактам и дизайнерам:

Дорогой друг! Не пиши текст в макетах нейросеткой, это только добавит всем работы: редактор ничего не поймёт и всё равно задаст тысячу вопросов, а потом всё переделает. Пиши своими словами, что должен понять и сделать пользователь на каждом шаге сценария

Обратите внимание, в списке выше собственно работы с текстом набралось три эпизода. Очевидно, один только ChatGPT мою рутину не упростит [9]. Нужен обучаемый ИИ-ассистент, понимающий контекст и умеющий интегрироваться с рабочими сервисами: вики, сервисом локализации, Джирой и Фигмой.

В идеале такой ассистент помогал бы мне следить за логикой изложения и единообразием терминов, вовремя обновлять словари, собирать текст по макетам в коллекции формулировок и вовремя подсвечивать отклонения от редполитики и ToV. Это сэкономило бы много времени и внимания, чтобы я, наконец, занялся какой-нибудь стратегией и исследованиями.

Умные инструменты сделают работу интереснее

Античный философ Сократ был противником популяризации письменности. Он считал, что без запоминания всех нужных знаний и обучения в диалоге греческая молодёжь утратит самостоятельность суждений. Но Сократ оказался прав не во всём — письменность освободила значительные когнитивные ресурсы и помогла мыслить глубже [10].

Доступные и гибкие ассистенты могут помочь нам с очередным скачком в мышлении за счёт его более эффективной организации. Сначала вы просто читаете всё подряд, потом собираете библиотеку и делаете заметки, после заводите хитрую картотеку, как у Никласа Лумана, а в итоге загружаете всё в ИИ-помощника и настраиваете его под свои задачи.

Благодаря машинному анализу накопленных знаний вдумчивый человек сможет вновь стать философом — неторопливо и глубоко размышлять на стыке дисциплин и задавать креативные вопросы, выводящие мышление за рамки привычных моделей.

Конечно, при условии, что пока появятся такие инструменты, мы не разучимся сосредотачиваться дольше 30 секунд, а на Земле не закончится электричество. Но его пока хватает, а вы дочитали до конца.

Примечания

Прошу прощения за архаичную вёрстку примечаний, но движок блога не предусматривает сноски, а дописывать его я не потяну. Поэтому переход по сноске перекидывает вас из ленты в статью.

  1. Тут я слукавил для драматизма. Нейросети строят логические выводы, но не на суждениях, а на предсказательных способностях. Последние итерации показывают приличные результаты, и в индустрии нет единого мнения по этому вопросу. Смотрите отчёт Apple от 2025 года The Illusion of Thinking. А в 2023 выходила статья Санджива Ароры и Анирудха Гояла про успешный тест на генерацию осмысленного текста. ↩︎

  1. Психологи считают, что творчество — это когнитивная деятельность, приводящая к новому или необычному видению проблемы или ситуации. Постоянное использование одного инструмента вырабатывает функциональную устойчивость, которая ограничивает креативность. Роберт Солсо, Когнитивная психология. 8-е изд., стр. 540 и 543. ↩︎

  1. Например, Сэм Альтман в эссе о мягкой сингулярности говорит, что искусственный сверхразум появится совсем скоро, нужно только подождать. Как Метавселенную экстремиста Цукерберга и Марсианский экспресс Илона Маска (он условно рукопожатный). ↩︎

  1. Статья в MIT Economics от 2023 года. Результаты исследования 444 человек показывают, что ChatGPT существенно повышает среднюю производительность работников с низкими способностями. ↩︎

  1. В ходе практики эксперты учатся распознавать специфические паттерны и организуют знания с точки зрения общих принципов, а не поверхностных характеристик. Солсо, стр. 347 и 567. ↩︎

  1. У меня нет прямых подтверждений именно этого факта, но есть косвенные. Во-первых, некоторые учёные не наблюдают эффект переноса. Во-вторых, исследования карт мозга показывают, что уроки музыки не обеспечивают ребёнка более качественным мозгом. Часы практики создают мозг, более подготовленный для игры на фортепиано. Ребекка Шварцлоуз, Ландшафты мозга, стр. 172. В-третьих, исследования профи по тетрису показывают, что они хорошо крутят в уме только фигуры из тетриса. Солсо, стр. 387—388. ↩︎

  1. В лучшем случае вы встретите упоминание определения по ISO 9241-210, но мало кто упоминает коллекцию определений EXPRESSO. Впрочем, мне встречалось мнение, что точные определения не так уж и нужны в работе. ↩︎

  1. Вполне вероятно, что нейросеть проигнорирует редко упоминаемые важные источники, например, сайт NN/g или Советы Бюро Горбунова. ↩︎

  1. Но это я. Владимир Лалош как-то рассказывал, что ChatGPT ему хорошо помогает. ↩︎

  1. Если Платон только записывал за Сократом, то Аристотель уже не мыслил себя без чтения. Марианна Вульф, Бесконечная история чтения, стр. 98—100 и 104—116. ↩︎

Благодарности

Никита Чернояров позвал меня на подкаст, задавал направление беседе и помог собрать всё в кучу.

Юлия Ушакова помогла свежим взглядом и острым умом.

К. Д. проверил самые важные тезисы на прочность, помог избавиться от лишнего и рассказал о нелёгкой доле современных джунов.

Кейс с совпадающими номерами

История про совпадения в номерах стикеров и понимание коммуникационной задачи. И почему нельзя просто так взять и сделать правильно.

Рабочие макеты под NDA, поэтому в этот раз только текстом.

Ситуация

Пользователю нужно подготовить поставку в пункт выдачи: пройтись по своему складу, собрать товары по списку, наклеить на них стикеры с уникальными номерами, упаковать и отвезти.

Чтобы человеку было удобно, разработчики придумали интерактивный чек-лист с нужными товарами и номерами стикеров. Абстрактно список выглядит так:

1245642 9258
9008731 9685
5748202 4973
4505331 9685
2356911 6736

Там ещё есть чекбоксы, фотки и названия товаров, но про макеты я уже говорил, просто представьте, что они там есть. Четыре последних цифры выделены — пользователям удобно по ним ориентироваться.

Фишка в том, что эти «хвосты» в большинстве случаев уникальны, но иногда совпадают у разных номеров, как в примере выше. И это проблема: пользователь может спутать, наклеить не тот стикер, и товар не примут.

Чтобы обратить внимание пользователя на совпадающие хвосты, команда решает подсветить их цветной плашкой и написать про это в справке к разделу. Наша задача — составить текст, не влезая в уже готовый дизайн.

Формальное решение

Сперва напишем, что просят, а потом будем рассуждать про дизайн, визуальную коммуникацию и основы когнитивной психологии.

Похожие стикеры подсвечиваются
Когда у разных стикеров совпадают последние 4 цифры, мы выделяем их цветом. Если встретили такой, обратите внимание на его полный номер

Теперь можно сформулировать коммуникационную задачу и начать думать. Задача коммуникации простая:

Обратить внимание пользователя на разные номера с одинаковыми «хвостами» и помочь не спутать стикеры

Очевидно, что в контексте задачи выделять «хвосты» цветом — плохое решение: мы привлекаем внимание к какому-то искусственному признаку, а не к важному. Как чиновники, когда подсвечивают знак пешеходного перехода вместо самого пешехода (смотри бессмертную заметку Лебедева).

Мало того. Мы привлекаем внимание к общей части различающихся сущностей, что помогает мало. Перефразируя один из гештальт-принципов, можно сказать, что похожие сущности воспринимаются, как связанные по смыслу. А нам нужно сделать акцент на их различии. Для этого можно выделить различающиеся части проблемных номеров:

1245642 9258
9008731 9685
5748202 4973
4505331 9685
2356911 6736

Выглядит так себе, но задачу решает.

Можно оставить выделение цветом, но дополнительно его усилить каким-нибудь сигналом. Например, значком:

9008731 9685 ⚠
5748202 4973
4505331 9685 ⚠

Спорно, конечно, но хорошее визуальное решение найдёт дизайнер, нам важнее показать общий принцип.

Системное решение

Всё по ТРИЗ: масштабно и безответственно. Изменить алгоритм генерации номера, чтобы исключить возможность путаницы. Например, генерировать номер так, чтобы в одной поставке не было одинаковых «хвостов».

А ещё лучше — генерировать номер на основе системного ID пользователя и даты сбора поставки с исключением номеров, совпадающих в последних 4 цифрах. Если вдруг не хватит разрядности, можно увеличить длину номера или перейти на шестнадцатеричную систему счисления, где вариантов будет примерно в шесть раз больше.

0000—9999 — 10 000 вариантов, 10 в 4 степени
0000—FFFF — 65 536 вариантов, 16 в 4 степени

Но решение с уникальной генерацией реализуемо только в принципе. Номерами, чек-листом и печатью стикеров заведуют разные команды. У каждой — свои приоритеты, ресурсы и горящие задачи. Никто просто не сможет протащить через владельца и скоординировать такое крупное изменение. В компаниях обычно просто нет продактов, которые таким занимаются. А у имеющихся зона ответственности и интересов ограничена задачами их команды.

Стоит добавить, что про «правильную» генерацию наверняка уже кто-то думал, но столкнулся с таким ворохом трудностей и зависимостей в реализации, который с лихвой перекрыл ожидаемую выгоду. Но мы не узнаем наверняка: на большинстве проектов не ведут поисковую документацию.

UPD. Статье нужен какой-нибудь афористичный вывод, так что вот он: продукт нужно проектировать до того, как он начнёт приносить прибыль. Потом уже будет не до этого.

Как придумать оригинальный софт-скилл

Придумывание ещё не изжёванных универсальных навыков для блогов бизнес-коучей — актуальная проблема современного интернета. В этой заметке мы разберём доступный способ решения этой задачи минимальными средствами.

Способ похож на описанный ранее в советах начинающим фантастам, но построен на более академичном подходе и новейших открытиях когнитивной психологии.

Сначала составим интуитивно понятный термин, смысл которого будет угадываться без точного определения. Для этого мы построим термин на сочетании известного и смутного.

Такой подход позволит читателю ощутить удовольствие от узнавания и активизирует его центры любопытства.

База термина будет существительным, означающим что-то хорошо известное. Например, мышление — понятие из психологии, с которым читатель наверняка сталкивается постоянно.

Для второй части возьмём понятие более размытое, суть которого читатель должен улавливать смутно. Подойдёт любое относительное прилагательное, которое описывает признак предмета через его отношение к другому предмету и отвечает на вопрос «какое?»

В нашем случае мышление может быть:

  • аналитическим
  • проактивным
  • пассионарным
  • левополушарным
  • дидактическим
  • дихотомическим
  • диалектическим

Да, каким угодно, главное — чтобы характеристика опиралась на наукообразную область. В этом случае значение термина сложится из суммы объёмов участвующих понятий и наследует признаки областей знания от своих составляющих.

Убедитесь, что получившийся термин не совпадает с уже описанным в профильных энциклопедиях. Если такой уже есть, прибавьте ещё одно-два прилагательных, можно через дефис. Например:

Дидактико-системное левополушарное мышление

Далее попросите нейросеть объяснить суть получившегося термина и поискать упоминания входящих в него слов в научной литературе. Соберите всё вместе и попросите нейросеть переписать более связно. Не забудьте добавить изображения мозга в разрезе и каких-нибудь таблиц и диаграмм.

Через несколько итераций у вас получится готовая статья об актуальном бизнес-навыке, которую при желании можно переупаковать в любой другой формат или расширить до книги.

Поле ввода с подсказками

Помогаем пользователю заполнить сложное поле и разбираемся, чем задача отличается от проблемы. Кейс свежий, детали под NDA, поэтому всё в условном дизайне и без конкретики.

Ситуация

Пользователю нужно заполнить графу с номером документа, подтверждающего качество товара. Бэк-офис проверяет документы, у товара в каталоге появляется отметка подлинности, и покупатели охотнее его берут.

Качество товаров в России подтверждают сертификаты и декларации соответствия

Нумерация у документов ожидаемо дикая, по четыре префикса на каждый вид:

ЕАЭС [N] RU [Д,С]-XX.YYYY.A.00000

РОСС RU [Д,С]-XX.YYYY.A.00000

ТС [N] RU [Д,С]-XX.YYYY.A.00000

RU [Д,С]-XX.YYYY.A.00000

У деклараций есть N и «Д» перед дефисом, у сертификатов пишем только «С». Остальные части номера тоже хитрые: сначала русские буквы и цифры, потом они же с латиницей, потом опять русская, потом только цифры.

Пользователи ожидаемо путаются, пишут в поддержку и плохо проводят время. Нужно помочь им разобраться и правильно всё ввести. Для этого фронты придумали узнавать префикс и накладывать на поле нужную маску:

Задача

Маску мы показываем, но пользователи всё ещё плохо понимают, где какие символы вводить. Когда пользователи ошибаются, форма ругается ошибками, но это не очень помогает.

Нужно как-то подсветить, что часть номера может состоять как из латинских символов, так и из русских. Есть памятка во всплывающем окне, где изложен весь этот ребус. Она написана по мотивам документации, нужно переписать по-человечески:

Как заполнить номер

С или Д — кириллические буквы. Символ принадлежности номера к сертификату/декларации соответствия

ХХ — кириллические буквы и цифры. Код страны изготовителя продукции

YYYY — латинские и кириллические буквы и цифры. Код органа по сертификации, выдавшего сертификат соответствия

А — только кириллические буквы. Тип объекта сертификации

00001 — только цифры. Порядковый номер сертификата соответствия

Такое получается, потому что постановщики задач в продукте часто мыслят категориями разработки и описывают в инструкции технические требования, а не порядок действий для человека. Это нормально.

Решение

Формальное. Изучим предмет и напишем памятку в понятном формате: какие бывают номера и какие буквы вводить. Про заглавные писать не будем, пусть фронты сделают перевод всех символов в верхний регистр. Остальное изложим от читателя. Заодно чуть поменяем маску, чтобы не обозначать русские буквы латинскими. Получится примерно так:

Как заполнить номер

1. Найдите номер документа

У сертификата номер в Росаккредитации указан внизу листа, а у декларации в самом верху.

Сертификат

— ЕАЭС RU С-ББ.YYYY.Г.00000

— РОСС RU С-ББ.YYYY.Г.00000

— ТС RU С-ББ.YYYY.Г.00000

— RU С-ББ.YYYY.Г.00000

Декларация

— ЕАЭС N RU Д-ББ.YYYY.Г.00000

— РОСС RU Д-ББ.YYYY.Г.00000

— ТС N RU Д-ББ.YYYY.Г.00000

— RU Д-ББ.YYYY.Г.00000

2. Начните вводить номер

Введите первые символы номера, и в поле появится подсказка с его форматом. Жирным выделена общая часть для всех номеров:

ЕАЭС RU С-ББ.YYYY.Г.00000

ББ — русские буквы и цифры

YYYY — цифры, русские или английские буквы

Г — русская буква

00000 — только цифры

Понятно, что изначальную проблему памятка не решает и нужно идти дальше. Хорошо бы не только написать в мире читателя, но и разобраться, где именно у него возникает проблема, и работать с ней по месту.

Полное. Очевидно, проблемы у пользователя возникают в момент ввода номера, а потому отрывать его от ввода и показывать памятку бессмысленно. Её нужно открыть, прочитать и запомнить, а потом ещё и применить. Поэтому стоит просто подсказывать нужное по мере ввода. Вот примерно так:

Маску можно распознать по первому символу: все четыре вида уникальны, а тип документа мы уже знаем

Можно ограничивать ввод по позиции курсора, но это сложнее в реализации и не факт, что сильно удобнее. Поэтому ограничимся подсказками и за кадром проработаем ошибки.

На этом стоило бы и закончить, но у нас есть ещё два решения.

Избыточное. Можно вместо маски показывать набор полей для каждой части номера. Выглядит серьёзно, но на деле только сделает дороже разработку и поддержку. Ещё это усложнит обработку при вставке из буфера обмена, а пользователи чаще всего копируют номер документа, а не набирают его руками. Вот так не нужно:

Идеальное. Сделать так, чтобы человеку вообще ничего не надо было вводить. Пусть номер считывает камера телефона и распознаёт нейросеть. Пока это возможно лишь технически, но когда-нибудь наша цивилизация покорит космос, и такие вещи станут ожидаемой нормой.

Выводы

Формальную часть решения у нас точно примут — она не противоречит условиям задачи и ситуации в команде продукта. А вот полное, скорее всего, завернут или добавят частями в конец бэклога. Решение нужно ещё вчера, есть задачи важнее, а разработчики и так вывихнули мозги, пока вкрячивали подстановку маски в типовое поле ввода, которое это не предусматривало.

Тем не менее задачи стоит решать полностью, чтобы собирать портфолио постепенно убеждать окружающих в пользе UX-специалистов. А заодно подкреплять идею, что пользовательские проблемы решаются не только редактурой текста, но и организацией смысла вообще.

Продолжение истории про эльфа и его друзей

В далёком уже 2021 году мы с художником-иллюстратором Ulv Vind печатали самодельную книжку «Заметки беспечного путешественника». В блоге был рассказ про неё.

UPD. Ноябрь 2024
Сайт книги mel.vitalyfilatov.ru
Бусти с книгой и дополнительными материалами

Так выглядел тираж версии 2021 года

Тираж мы распродали и думали заняться чем-нибудь другим, но читатели просили продолжение. Так что мы собрались, дописали-дорисовали книжку до полноценной повести с добротным эпилогом. А теперь предлагаем вам её почитать.

О чём книга

Молодой эльф Мелентор отправляется в долгожданное путешествие и записывает всё увиденное в дорожном дневнике. В таверне он встречает пройдоху-следопыта и молчаливого мечника, с которыми решает совершить дерзкое ограбление дракона. Конечно же, этот поход не приносит добычи, а одни неприятности. И теперь героям предстоит осознать все последствия и попытаться их исправить…

Чем книга интересна

Она сказочная и с картинками

Главное достоинство нашей истории — она простая, добрая и написана от лица интеллигентного эльфа. В ней нет безысходной мрачности тёмного фэнтези, жестоких сцен и грубых выражений. Так что её можно читать детям и дарить любителям лёгкого фэнтези.

Основные темы повести: дружба, ответственность за поступки и красота волшебного мира. Наши герои не выясняют отношений и не тонут в рефлексии, они беспечно гуляют по лесам-болотам и без истерик справляются с трудностями.

А ещё в книге много красивых иллюстраций, которые интересно рассматривать.

История собрана вокруг игры с жанром

Мы не стали оригинальничать и сосредоточились на том, чему научились по настольным ролевым играм — игре в персонажа. Наш рассказчик — талантливый дилетант: он субъективен и несведущ в литературном ремесле, а часть важных событий происходит за пределами его внимания.

Эта игра в постфэнтези роуд-муви привела нас к «постмодернизму здорового человека». История прикидывается модерном, делая вид, что до неё никакого фэнтези не было, вместе с тем в меру интеллигентно опирается на устоявшиеся жанровые тропы: концепцию научной магии, базовые расы, героическое прошлое родственников, вот это всё.

Герой-рассказчик не преследует цели развлечь читателя, а просто по порядку излагает увиденное в своих первых трёх походах. В то же время книга взрослеет вместе с автором. Если первый поход занимает три страницы обрывочных заметок, второй под 60 страниц дневника, то третий уже написан как полноценная повесть.

Дварф и его драконовая ящерица

По книге можно изучать цикл производства

Я UX-редактор, а Ulv — профессиональный художник. Конечно же, наша книжка — типичный информационный продукт, прошедший все стадии от MVP-уродца до полноценного проекта.

Книг мы до этого не писали, а потому собрали все возможные грабли, утонули в проблемах и героически их преодолевали. В итоге мы преисполнились и применили проектный подход, наша книжка выросла в полноценный проект, а проблемы в итоге привели к некоторым удачным решениям.

В тексте видны следы дыр, нестыковок и последствий срочных решений, но вместе с тем, можно проследить поэтапное взросление идеи произведения и нашего подхода к работе. В дополнительных материалах на Бусти мы про всё это потихоньку рассказываем.

Где читать

На Бусти, по главам. Сама книга с иллюстрациями доступна бесплатно, дополнительные материалы — по платной подписке.

Сам бусти — https://boosty.to/melentor

Оглавление и ссылки на материалы по книге

PDF-версия появится на Бусти, когда я её доверстаю, а литредактор её вычитает. Ориентировочные сроки — середина лета 2024. Следите за новостями.

Бумажная версия — TBD. Мы планируем печатать книгу в твёрдом переплёте на хорошей бумаге, но когда это будет и сколько будет стоить, пока не ясно. Следите за новостями и подписывайтесь на обновления, чтобы ничего не пропустить.

Заметки о работе UX-редактором

Мой стендап про UX-редактуру для канала «Наташин UX». Хвастаюсь корешками книг, кошусь мимо камеры и рассказываю, как попал в UX, какую пользу приносит редактор, откуда в продуктах берётся плохой текст, почему его сложно исправить и чем полезна работа в банке.

Смотреть на Ютубе с подробными таймкодами

Ролик вышел в сентябре 2023, тогда я ещё работал в Умном доме МТС

Если у вас нет свободных 51 минуты 47 секунд, чтобы на меня смотреть, вот тезисы:

Про учёбу

Учится на курсах полезно, но перед этим хорошо начитаться интернета. Тогда курсы помогут систематизировать знания и понять, что и как изучать дальше. Без базы курсы дают только общее представление о предмете.

Знания нужно систематизировать и хранить в базе знаний. Например, завести Цеттелькастен в Обсидиане.

Первичный опыт в UX можно получить на смежной роли. Например, писать статьи в Помощь, попутно изучать продукт, а потом предлагать дизайнерам и продактам что-нибудь переписать.

Для системной работы нужны знания из смежных областей: основы программирования, типографика, вёрстка, дизайн, Фигма. Чем больше таких знаний, тем больше влияния на продукт.

Про смысл

Интерфейс — это диалог с пользователем. Чтобы диалог был осмысленным, нужно начинать с сути. Сначала решаем, зачем и что сказать, потом — какими словами.

Чтобы решить интерфейсную задачу, нужно понимать контекст: откуда пользователь пришёл, что хочет сделать, что уже знает, какие ограничения есть у бизнеса и разработчиков. Для этого редактору нужно задавать много вопросов, а продакту — быть готовым на них отвечать.

Ошибки в крупных продуктах

Ошибки и неряшливость возникают в зонах, где нет ответственного. Так происходит из-за бюрократии, бардака и бэклога.

Некоторые ошибки не будут исправлять, пока они не начнут ощутимо вредить бизнесу. Некоторые ошибки не начнут вредить никогда. Но в мире нет ничего вечного, когда-нибудь они сгинут вместе с продуктом.

Разработчики тоже любят пользователей и хотят делать хорошо. Но они воспринимают продукт изнутри, а потому иногда творят дичь: хардкодят модальные окна или выводят ошибки базы данных в интерфейс.

Как быть полезным

У любой команды до редактора уже есть какие-то процессы. И прежде чем выстраивать новые, нужно изучить старые. Так меньше шансов что-то сломать и всех выбесить.

Важно создавать коалиции. Тогда редактор будет выражать не субъективное мнение, а мнение группы компетентных специалистов.

Важно понимать, что хочет постановщик задачи. Если продакт принёс мелких правок за день до релиза, глупо предлагать изменения в сценариях. Остаётся постепенно наглядно убеждать в своей пользе и ждать, когда к тебе начнут приходить пораньше.

Чтобы к редактору было больше доверия, нужно делать то, что от вас ждут, но чуть больше и чуть удобнее. За полгода в вас поверят.

UX не только про пользователя, но и про команду: дизайнеров, разработчиков, аналитиков и менеджеров. Если с редактором тяжело работать, к нему будут реже ходить, даже если этого требует регламент.

Всякое по теме

#14 — Кто такой UX-редактор — подкаст лаборатории Mish. Если из видео ничего не понятно, послушайте его.

Как я строил коптеры и снимал видео — чем я занимался до редактуры.

Технический долг и легаси на примере тараканов — почему некоторые вещи так сложно исправить.

Заявка с пятью полями загрузки — почему корпорация сильна, но человек в ней слаб и одинок.

Сила маркера и скотча

Помогал проводить ролевую игру по Сталкеру: следил за работой игровой локации, изображавшей заброшенную лабораторию. Я проверял на входе ключ-пропуск и снаряжение, напоминал правила и следил за временем забегов, а в перерывах подкидывал внутрь игровые ценности и дымовые шашки.

В ходе игры выяснилось, что локация работает непонятно и неудобно. Пришлось решать на месте подручными средствами.

Ситуация

Лабораторию устроили в заброшенном овощехранилище. Закрыли окна и лишние двери, оставив два входа: один для игроков, другой для организаторов. Служебный вход пометили сигнальной лентой, а на игровой повесили старый кассовый аппарат в роли кодового замка на шлюзе.

В неигровой зоне я ждал игроков и хранил реквизит

Оказалось, что локация непонятно и неудобно организована.

Непонятки. По задумке я должен был встречать игроков внутри, проверять ключ-пропуск и запускать в лабораторию. Но иногда игроки просто шли мимо и решали проверить дверь со странной штукой. Они врывались внутрь, осматривали углы и иногда успевали пробежать мимо меня в неигровую зону или лабораторию. Приходилось их останавливать, а это сбивало кураж и портило погружение.

Неудобки. Локация работала с утра до двух ночи, сидеть там постоянно не получалось. Пока меня не было, локация портила игру: игроки без ключа решали, что закрытые двери ведут в неигровые зоны, а игроки с ключом не знали, когда я вернусь, и теряли время.

Решение

У меня был маркер, бумага и двухсторонний скотч, поэтому я написал таблички.

Первой я повесил табличку на входе. Двери в лабораторию и неигровую зону закрывались навесными замками, а входная нет, да и закрывать её было бессмысленно — всё равно непонятно, что это и как с этим играть. Нужна была четкая инструкция, отсекающая кейс неавторизованного входа.

Неприметная дверь в заросшем закутке вела в полный опасностей лабиринт
Понятно, что это игровая зона и нужен игровой предмет, а мне нужно поработать над леттерингом

После этого случайные посетители перестали забегать, а игроки с ключами показывали их с порога.

Внутри я повесил ещё по табличке на каждую дверь. На неигровую — пояснение со стрелкой, а на игровую — инструкцию с подсказкой.

Рация есть у каждого, но за сутки она может разрядиться

После этого я смог смело ходить по делам, а игроки меня не теряли.

Выводы

  1. Интерфейсы и процессы есть везде, где есть люди.
  2. Пользовательский опыт нужно целенаправленно организовывать, иначе люди организуют его себе сами как сумеют.
  3. Суть важнее формы. Вовремя и кое-как лучше, чем красиво, но поздно.
  4. Люди читают, если текст выглядит важным. Просто важность субъективна и зависит от контекста и внимания.
Ранее Ctrl + ↓
UX